C++入门
C++ 入门
根据 B 站码农论坛视频、黑马笔记、《C++ Primer Plus(第 6 版)中文版》整理的笔记。
搭建开发环境
vscode 远程连接 Linux 服务器
vscode 这边只需要安装 C++、CMake Tools 插件即可。
我们需要搭建 Linux 的开发环境。我采用的服务器是 Ubuntu22.04 。需要在终端执行以下命令来配置开发环境。
# 1.更新包列表: 更新包管理器的包列表,确保你能从最新的仓库中获取软件。
sudo apt update

# 2.安装 GCC 编译器 : GCC 是 GNU Compiler Collection 的简称,是最常用的C和C++编译器。
sudo apt install gcc

# 3.安装构建工具: build-essential 包提供了很多开发标准C和C++程序所需的工具。
# 包括 g++(GNU C++ 编译器)、make(用于自动化编译的工具)和一些其他必要的库和开发文件。
sudo apt install build-essential

# 3.安装调试工具
sudo apt install gdb

# 3.安装检测内存泄漏工具 valgrind
sudo apt install valgrind

# Valgrind 主要用于内存泄露检测、内存调试以及性能分析的工具。
接下来要用 vscode 远程连接服务器:
- 服务端手动启动 Openssh 服务(openssh 是实现 ssh 协议的软件)
sudo apt update
sudo apt install openssh-server # 安装 OpenSSH 服务器,以支持 ssh 连接 我买的是阿里云服务器,没有执行这条命令,也可以进行远程连接。
sudo systemctl start ssh
sudo systemctl enable ssh
检查是否开启 ssh 服务
sudo systemctl status ssh- vscode 端安装 remote-ssh 插件(用 trae 的话不用安这个插件,直接用远程资源管理器。)
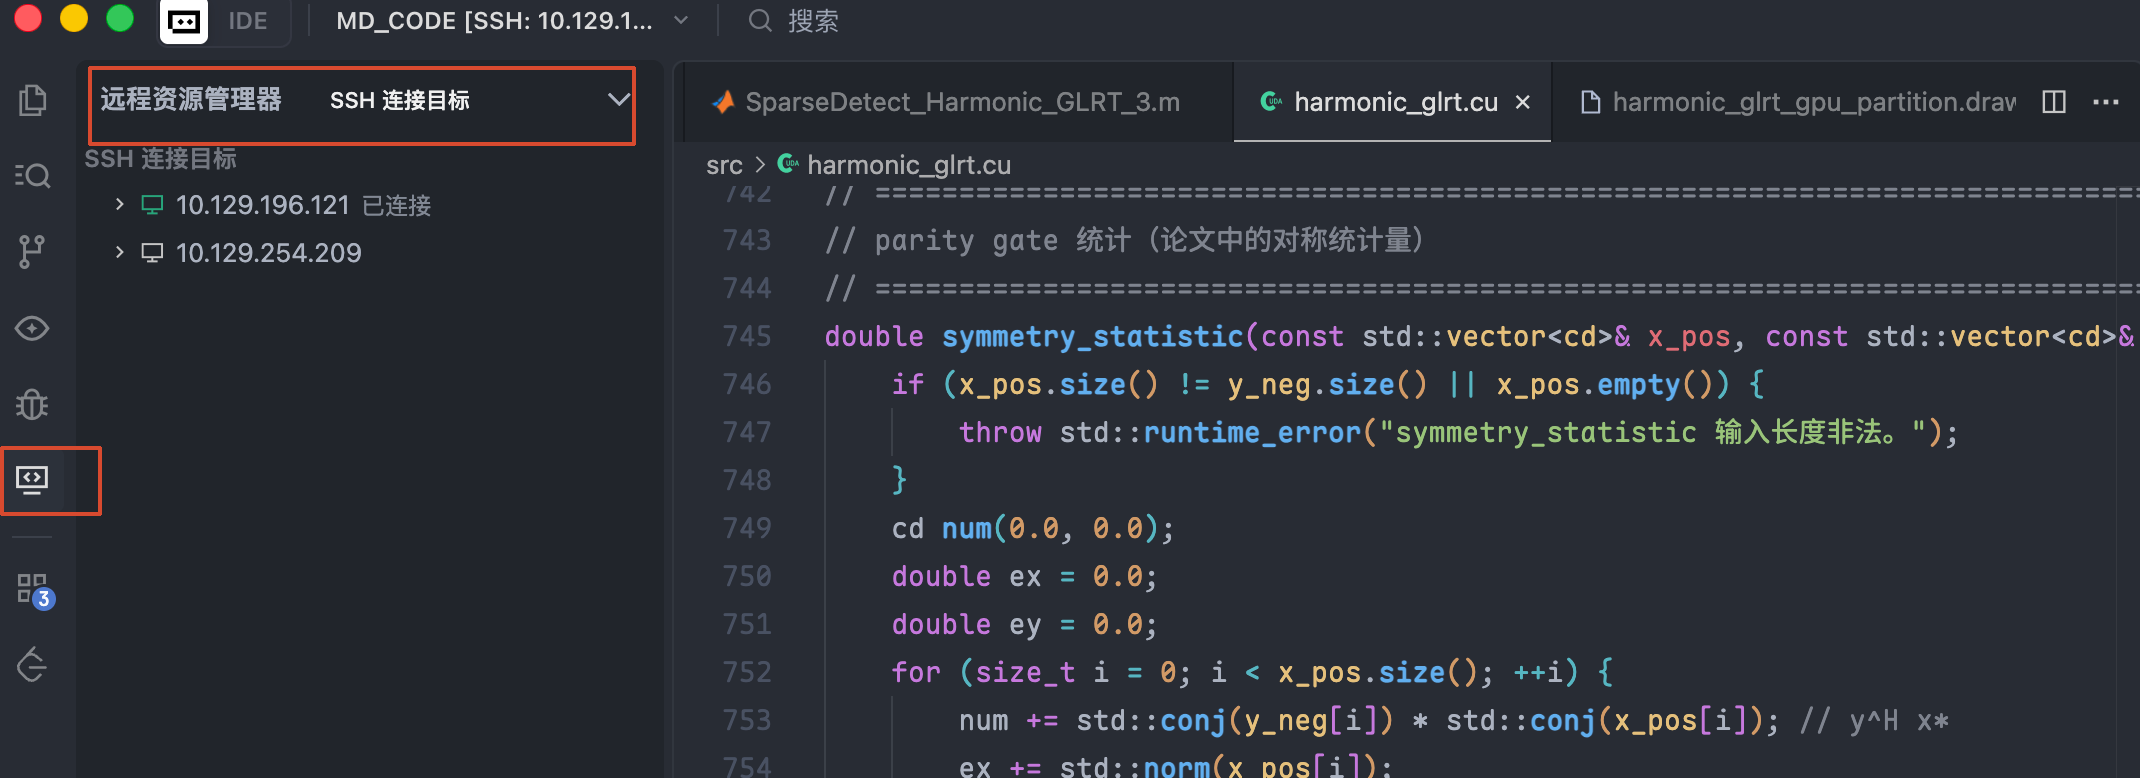
远程连接
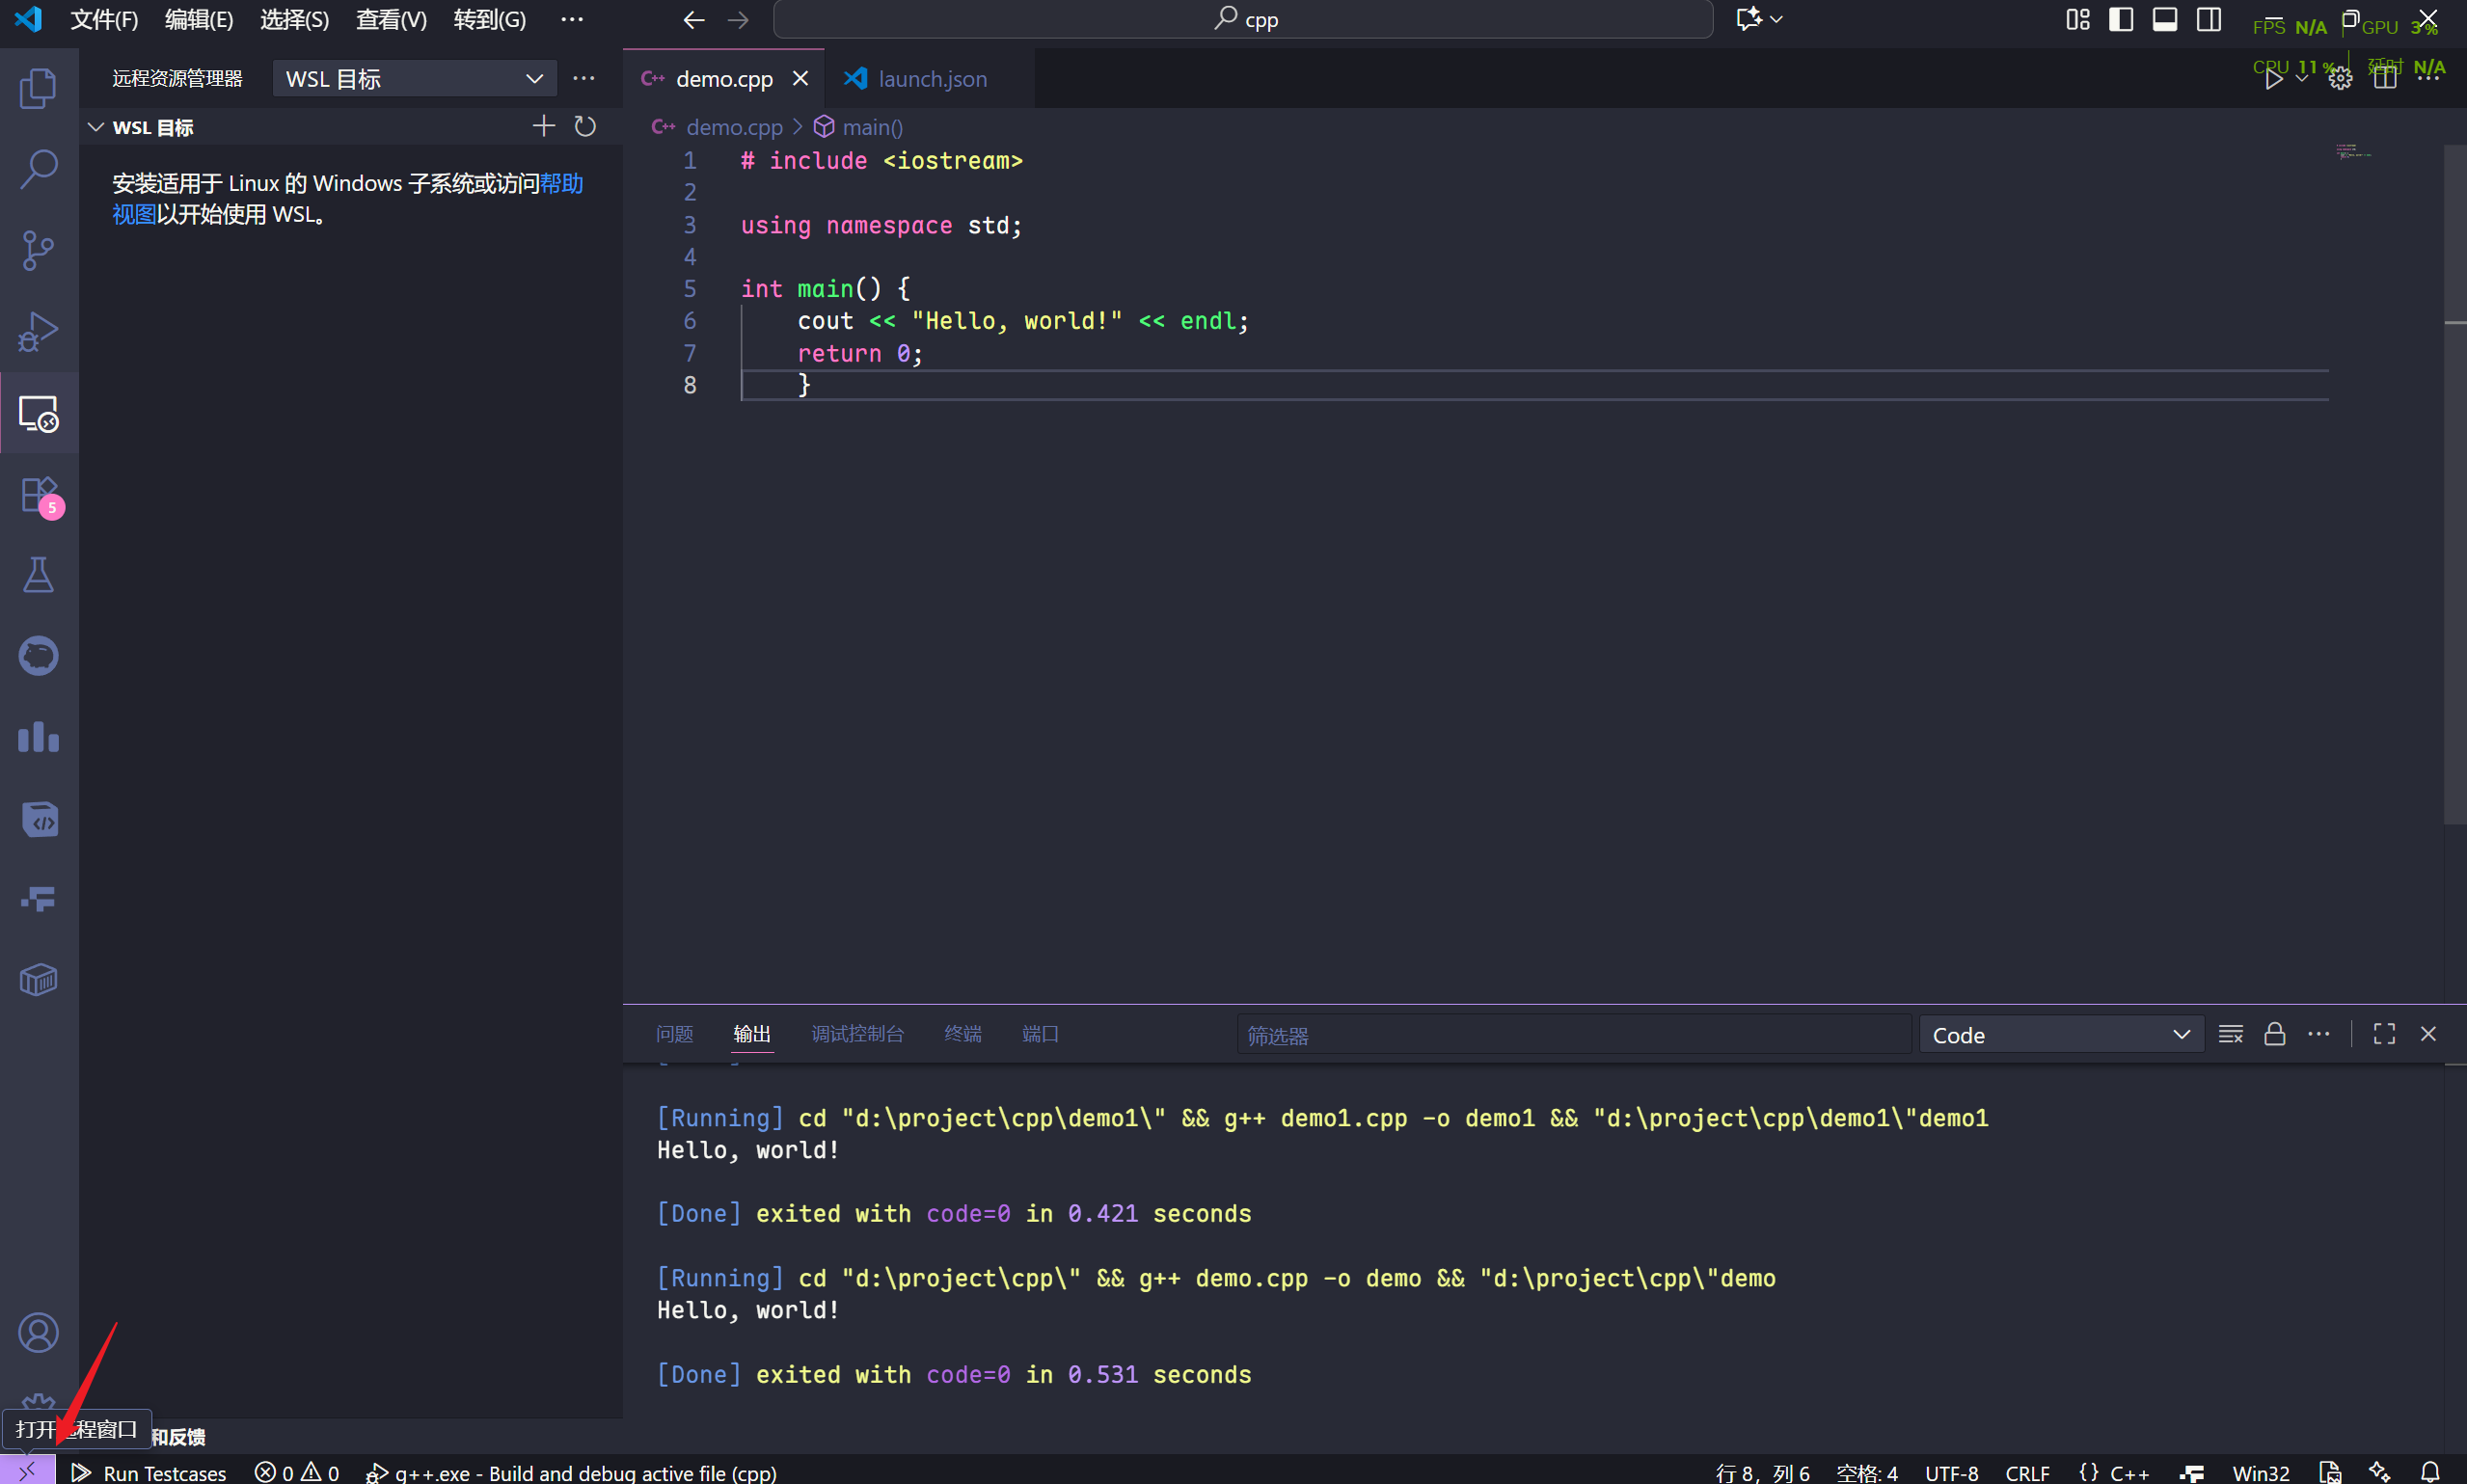
image-20250919101426186 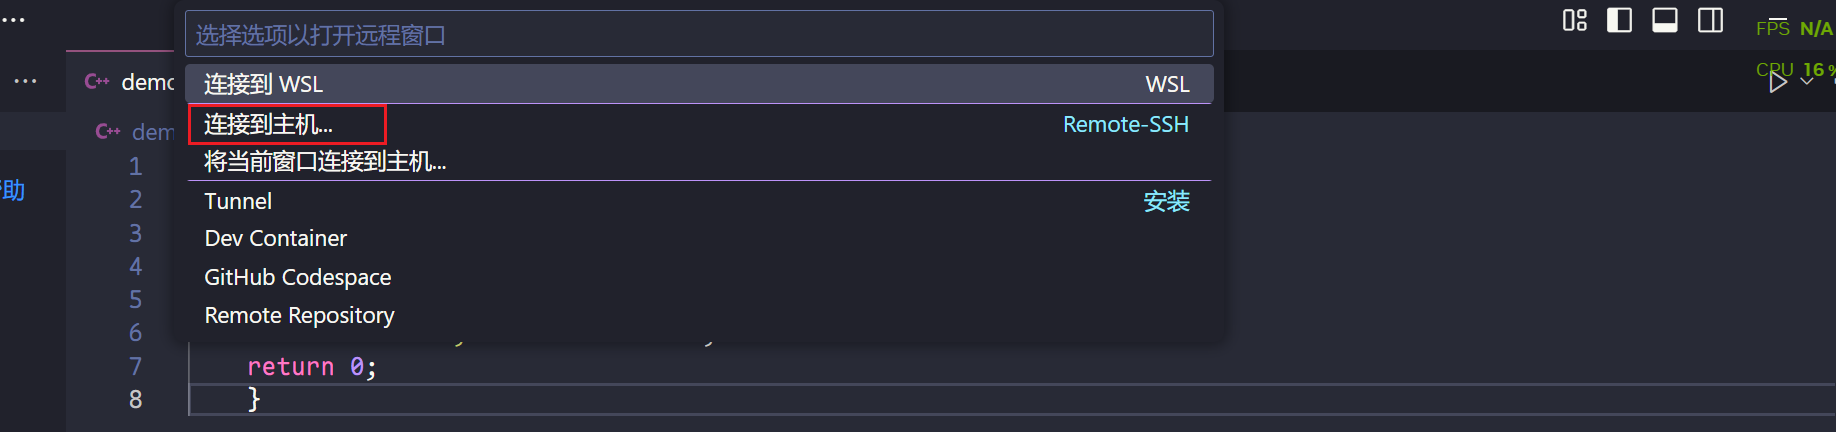
image-20250919101443983 输入
用户名@host -A。host 指的 Linux 服务器的 IP 地址。可以通过ifconfig查看。(ifconfig 查看的是内网 IP。)vscode 远程连接 Centos 系统报错:无法建立连接:远程主机不满足运行 vscode 服务器的先决条件。
原因是 VS Code 远程开发需要 glibc ≥ 2.28。
通过命令 ldd --version 查看 glibc 版本发现低于 2.28。
解决办法:回退 vscode 版本 1.98。
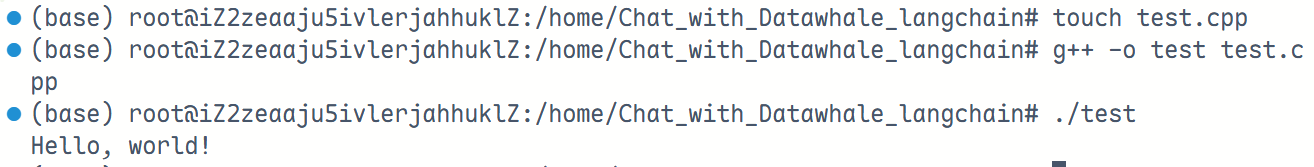
判断开发环境是否搭建完成:
#include <iostream>

using std::cout;
using std::endl;

int main() {
    cout << "Hello, world!" << endl;
    return 0;
}
每次远程登陆 Linux 都需要输入密码,很麻烦,下面介绍如何才能免密登陆。
- 生成密钥对:输入
ssh-keygen -t rsa -b 2048 -f C:\Users\YourUsername\.ssh\id_rsa_windows,一路回车。会生成两个文件,一个公钥id_rsa_windows.pub、一个私钥id_rsa_windows。- 打开
id_rsa_windows.pub文件,复制上面的内容。- 把本地 ssh 公钥复制到 Linux 端:粘贴到 Linux 端的
~/.ssh/authorized_keys文件中。- 手动指定私钥位置:打开 ssh 客户端配置文件
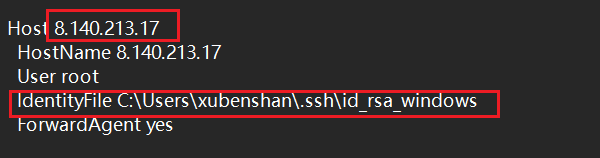
C:\Users\YourUsername\.ssh\config。把私钥文件路径IdentityFile C:\Users\xubenshan\.ssh\id_rsa_windows粘贴到 config 中的对应 Linux 服务器 IP 的位置。如下图所示。
场景:连接的是实验室的服务器,需要配置下 ssh 公钥。把本地的公钥也就是
id_rsa.pub复制到服务器~/.ssh/authorized_keys~ 是当前登录用户的主目录。不需要手动指定私钥位置,因为 ssh 客户端会自动去寻找id_rsa文件。前面之所以要指定,是因为公钥私钥名字是自定义的,不是系统默认的。
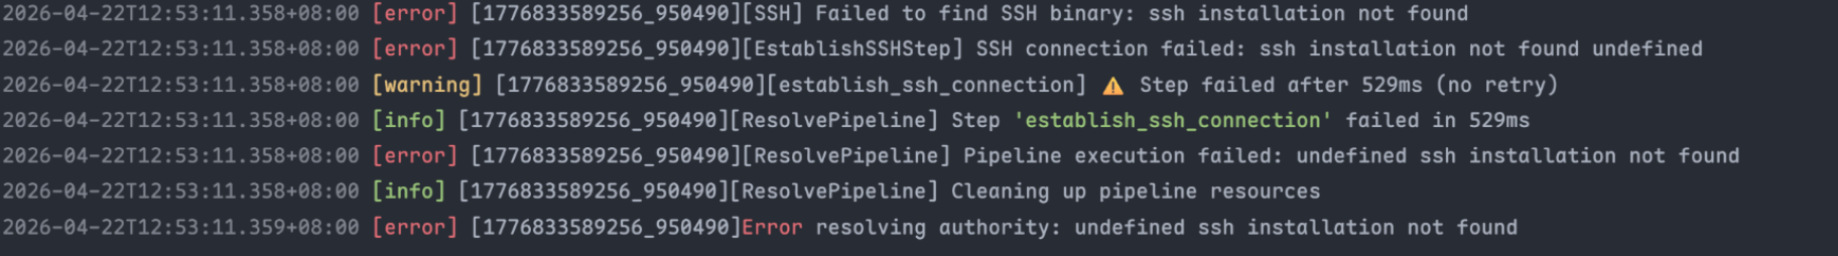
image-20260429114828427 如果报上述错误,windows 下搜索可选功能,安装 openssh 客户端。(正常来说 window10 以上系统和 mac 会自带 openssh 客户端服务。)
ssh 免密登录的流程:
- 客户端选择一个候选身份,比如~/.ssh/id_ed25519
- 客户端取出这个身份对应的公钥
- 客户端问服务器:这个公钥你接受吗?
- 服务器检查 authorized_keys,里面有没有这个公钥
- 如果接受,服务器说:可以,证明你有私钥
- 客户端用对应私钥签名
- 服务器验证签名,通过后登录成功
误区:客户端不是遍历本地所有的 pub 公钥,而是遍历已知候选身份对应的公钥。
已知候选身份列表一般来源:
- 默认私钥文件名
~/.ssh/id_ed25519
~/.ssh/id_ecdsa
~/.ssh/id_rsa
等- ~/.ssh/config 里的 IdentityFile
- ssh-agent 里已经加载的密钥
- 命令行 -i 指定的私钥
私钥可以推出公钥,所以本地删除公钥,不影响免密连接。
使用 g++ 对源文件进行编译:
| -o | 指定可执行文件名 | g++ -o test test.cpp |
|---|---|---|
| -std=c++11 | 指定 C++11 标准 | |
| -g | 对源代码进行编译 | |
| -O | 在编译链接过程中进行优化处理 | |
| -c | 只编译,生成汇编文件,不链接成为可执行文件 |
拓展:vscode 常用快捷键
ctrl+d 选中下一个相同的内容
alt + 上下键 整行代码上移或下移
alt + 左键 在任意位置添加光标,同时在不同位置打字
ctrl+p 跳转文件
ctrl+b 收起侧边栏
ctrl+j 打开终端
shift+alt+→ 扩展选中的内容
CLion 配置 C++ 环境
为了能在控制台正确显示中文,需要在 main 函数中加入以下代码:
system("chcp 65001");vscode 配置 C++ 环境
编译器下载
采用 gcc 编译器,mingw 里面包含 gcc。
下载 MinGW-w64
下载地址:https://link.zhihu.com/?target=https%3A//github.com/niXman/mingw-builds-binaries/releases
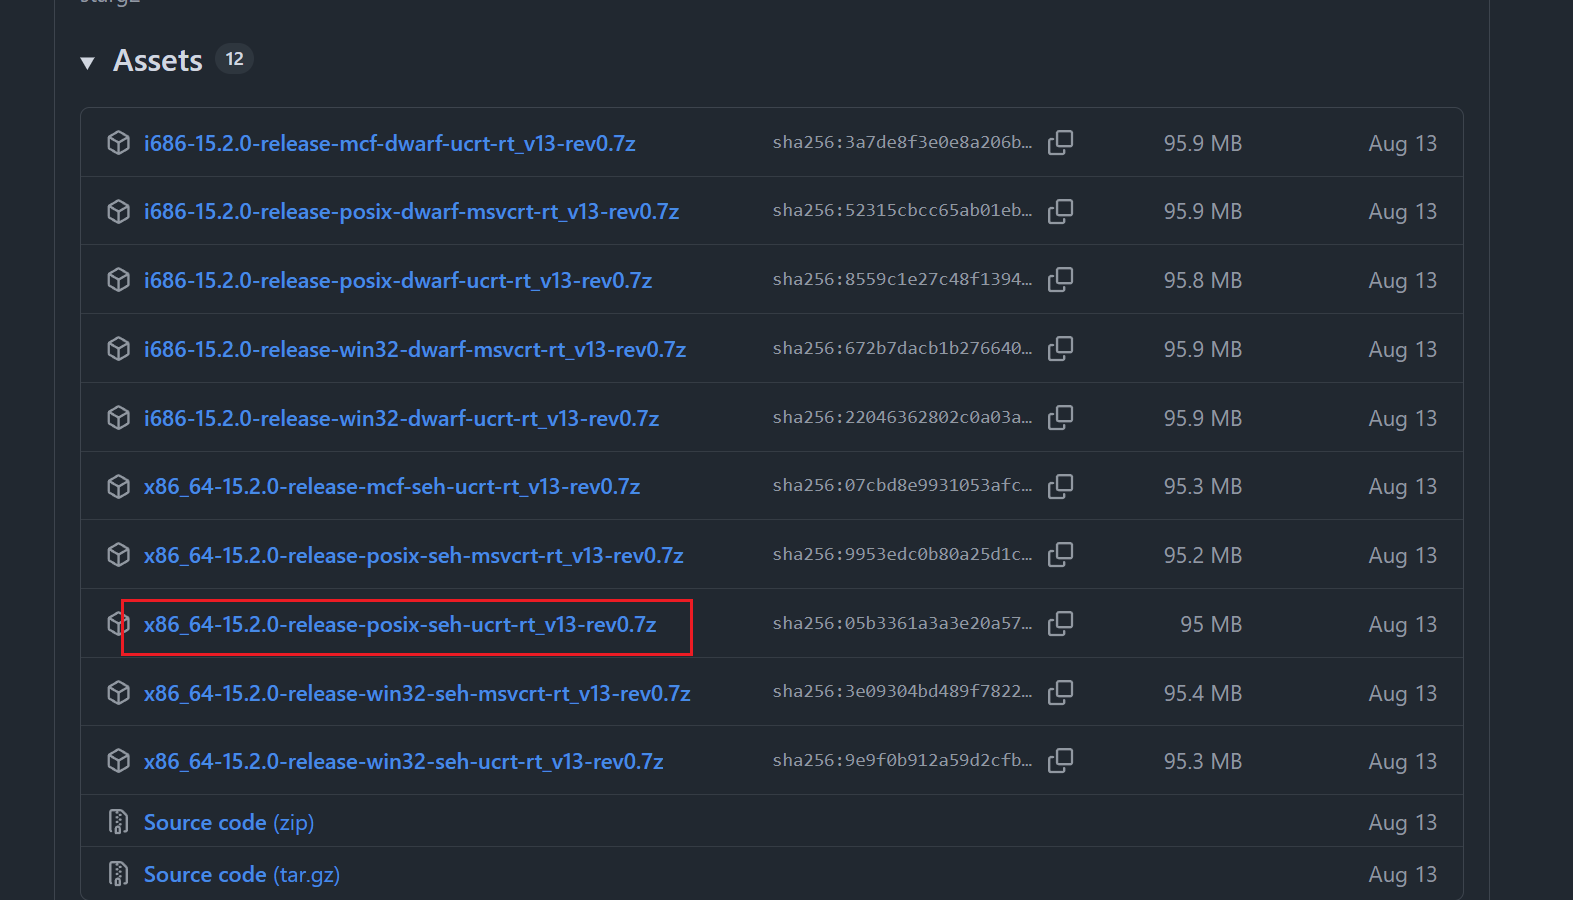
解压到 D 盘 mingw64 文件夹中。
配置环境变量:
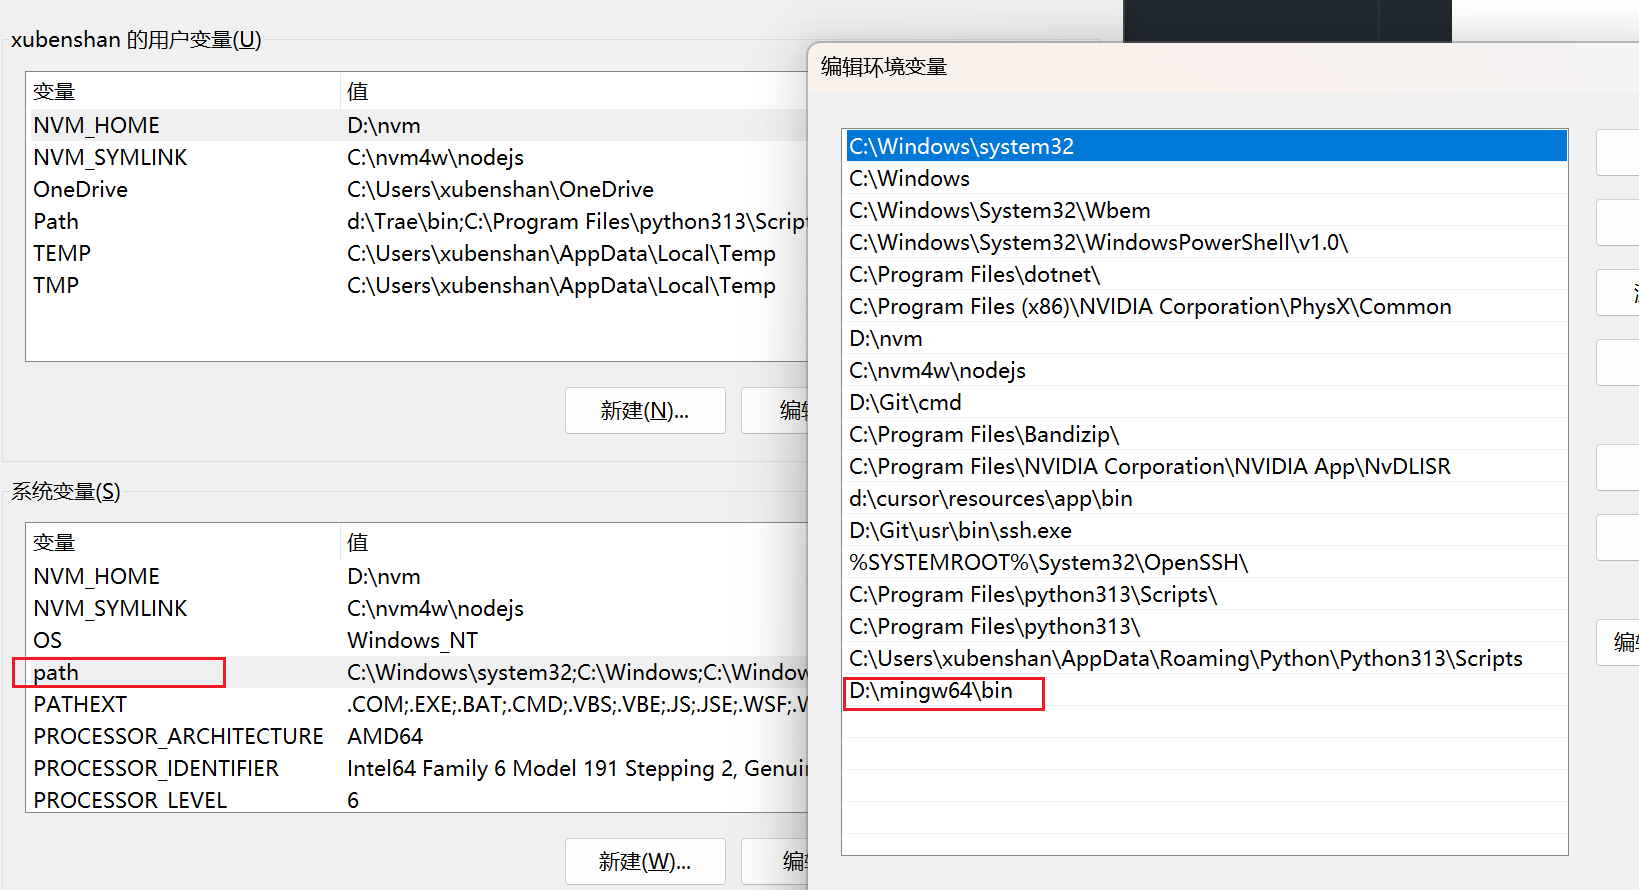
win+i 打开设置,点击系统,下滑找到系统信息,点击高级系统设置 - 环境变量。将路径添加到系统变量 Path 中。
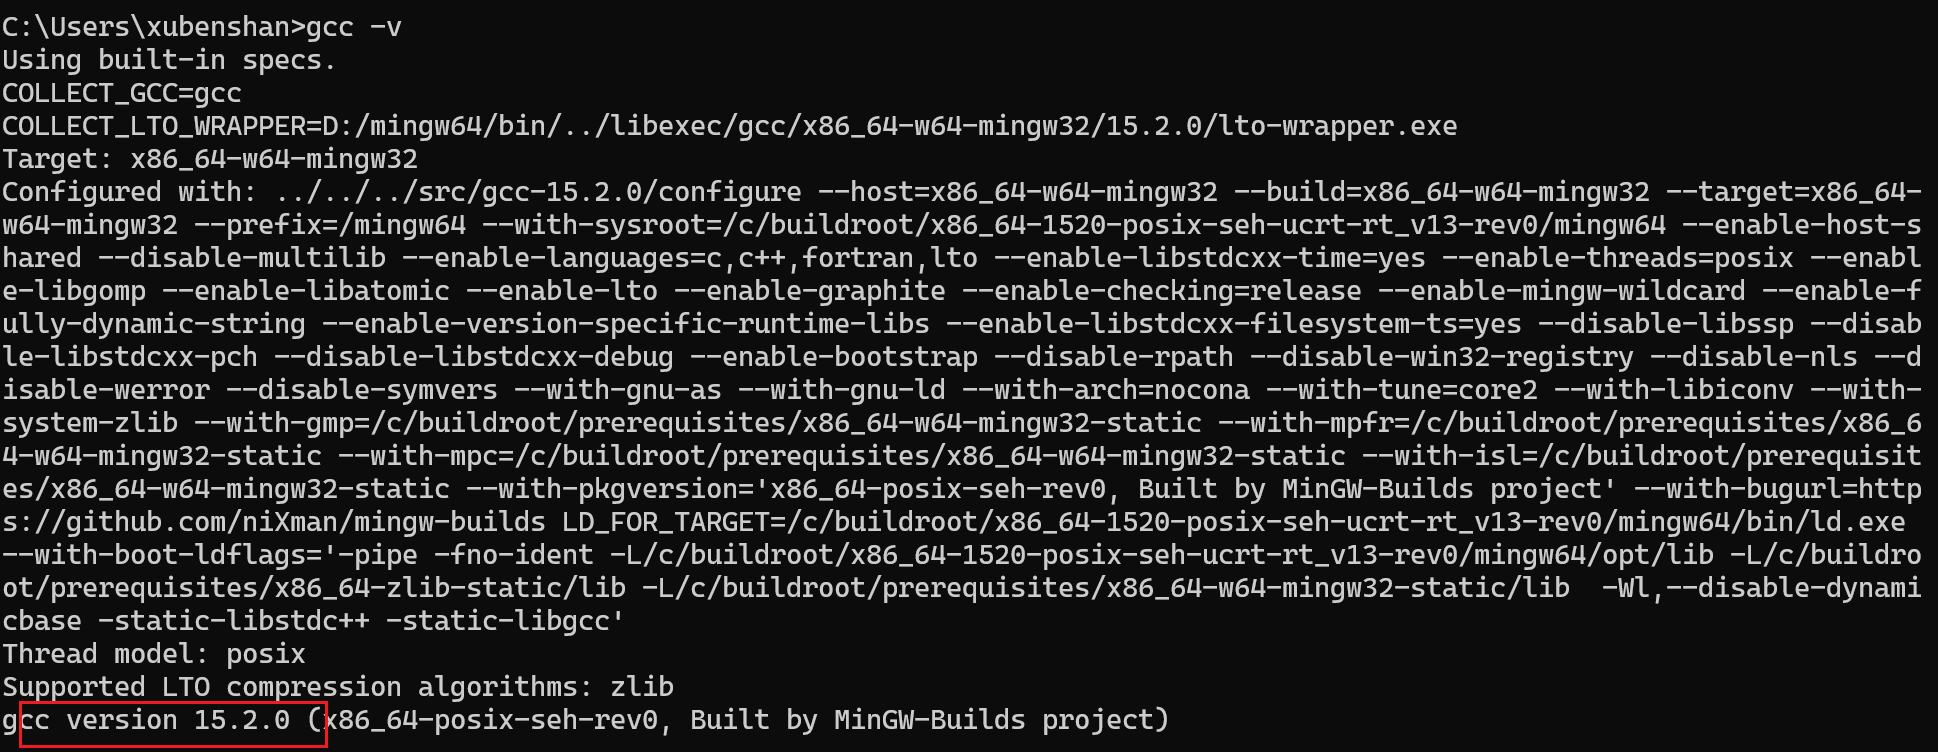
win+r 输入 cmd,打开终端。输入 gcc -v,查看是否配置成功。
安装插件
code runner
C/C++
C/C++ Extension Pack
配置编译环境
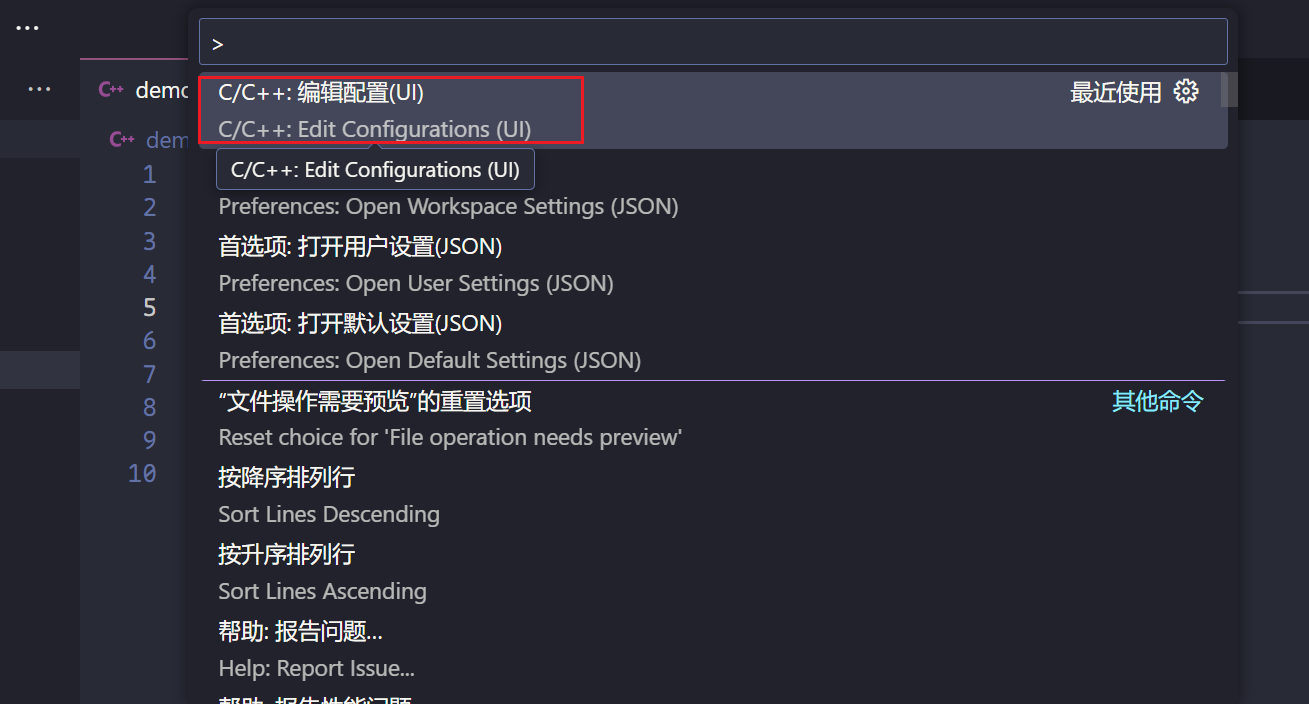
c_cpp_properties.json
利用插件自动生成代码。
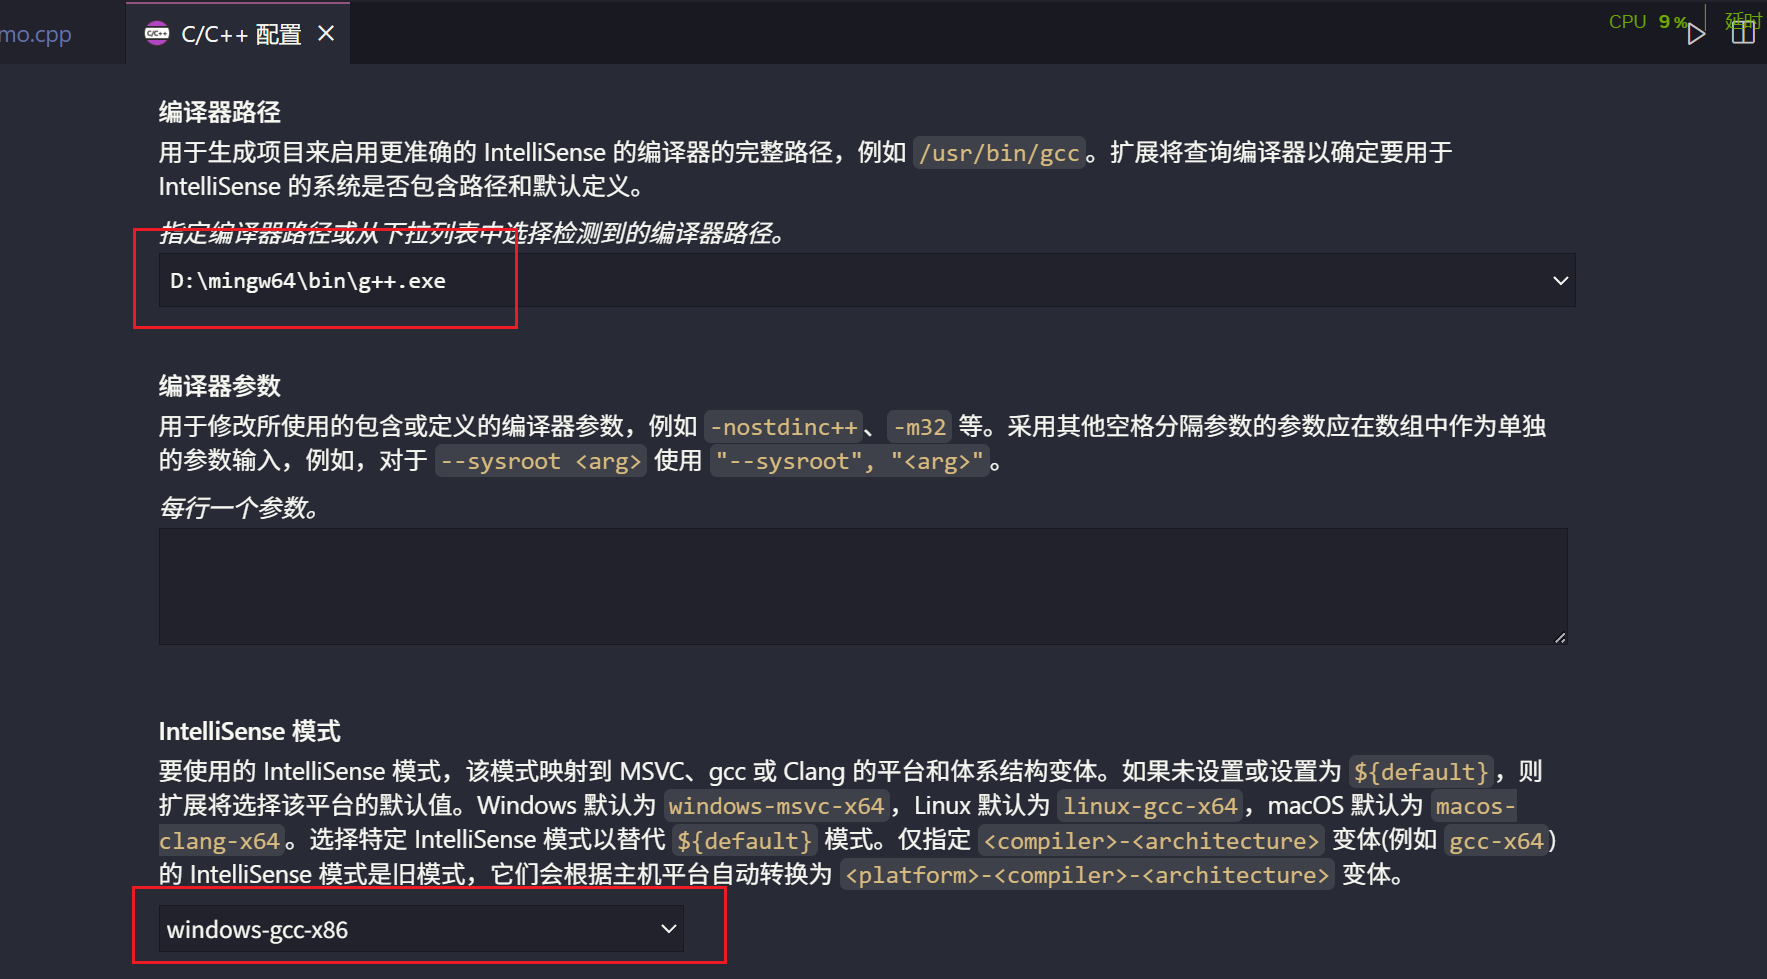
更改配置:
launch.json :调试代码用的。
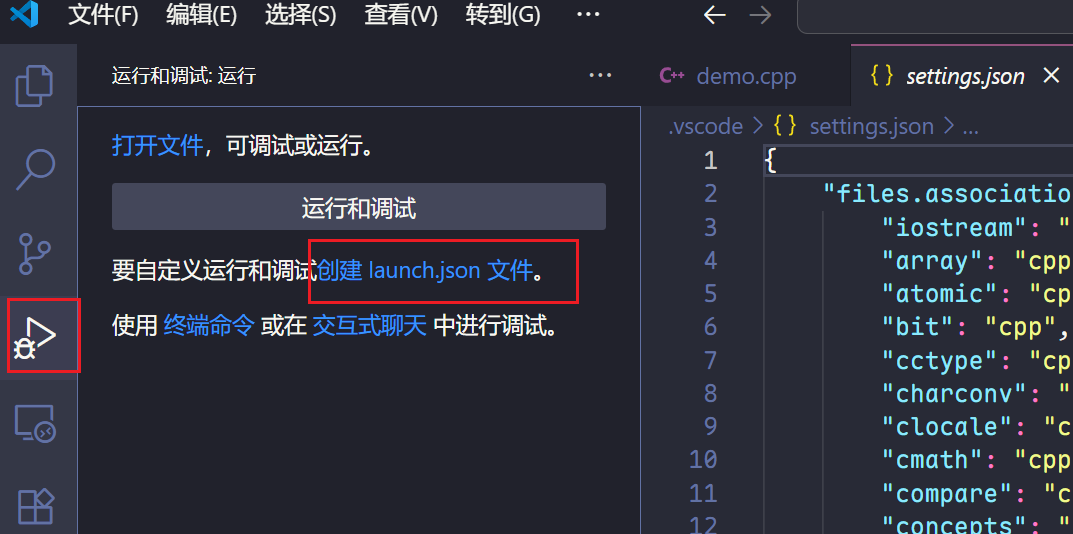
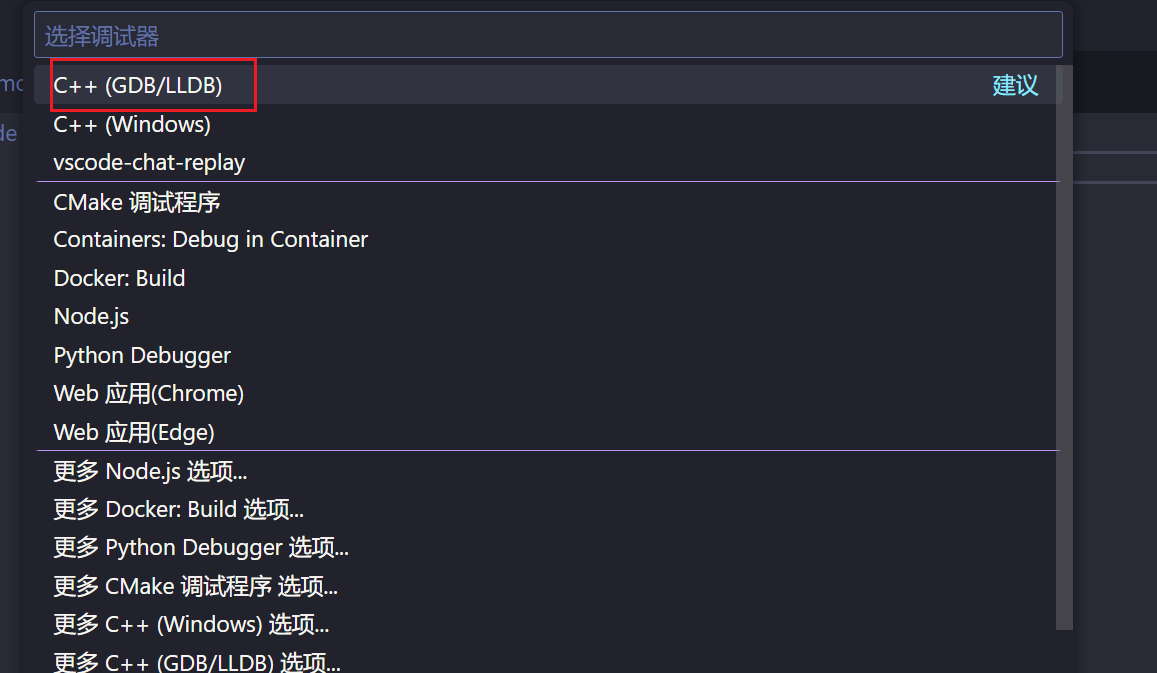
{
    "version": "0.2.0",
    "configurations": [
        {
            "name": "g++.exe - Build and debug active file",
            "type": "cppdbg",
            "request": "launch",
            "program": "${fileDirname}\\${fileBasenameNoExtension}.exe",
            "args": [],
            "stopAtEntry": false,
            "cwd": "${fileDirname}",
            "environment": [],
            "externalConsole": false,
            "MIMode": "gdb",
            "miDebuggerPath": "D:\\mingw64\\bin\\gdb.exe",
            "setupCommands": [
                {
                    "description": "Enable pretty-printing for gdb",
                    "text": "-enable-pretty-printing",
                    "ignoreFailures": true
                }
            ],
            "preLaunchTask": "C/C++: g++.exe 生成活动文件"
        }

    ]
}
tasks.json :用来将代码编译成可执行文件
终端 - 配置任务
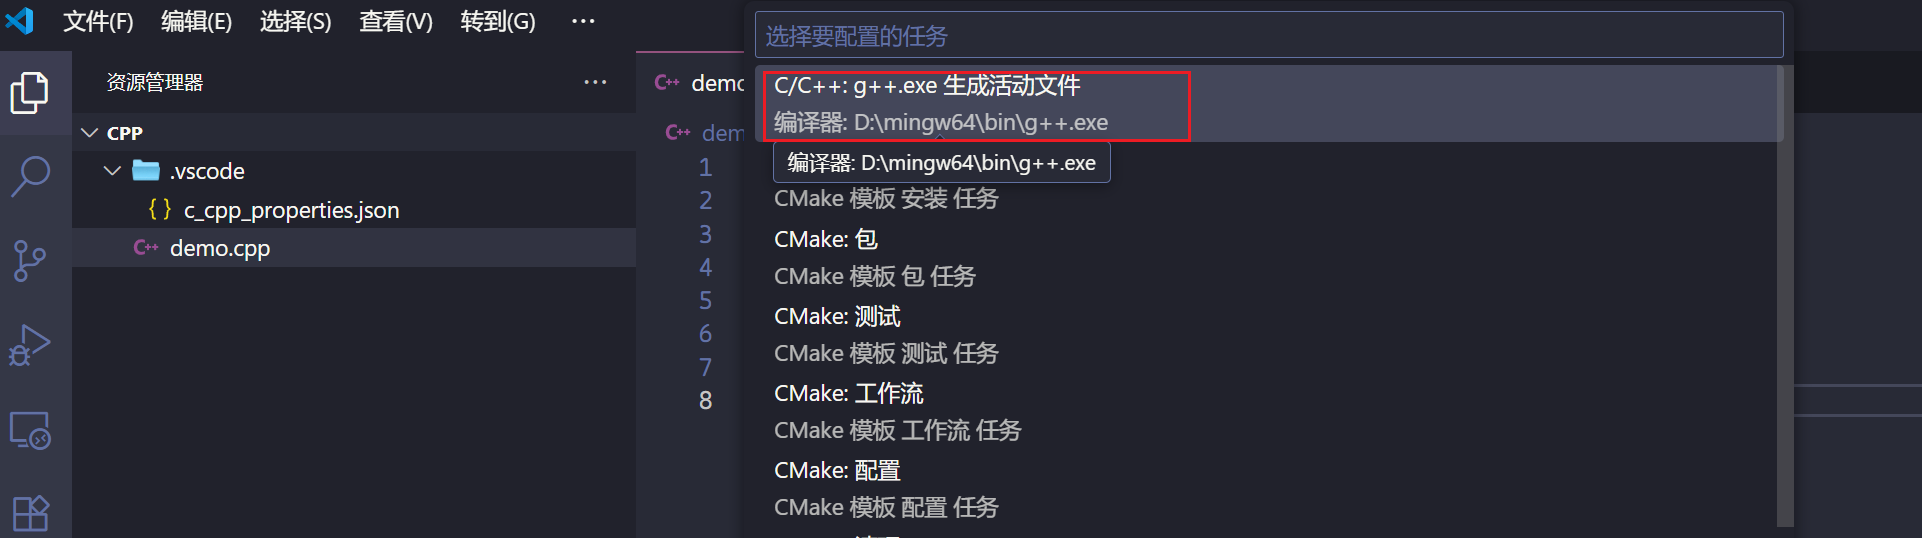
点击运行代码,若出现乱码,重启即可。
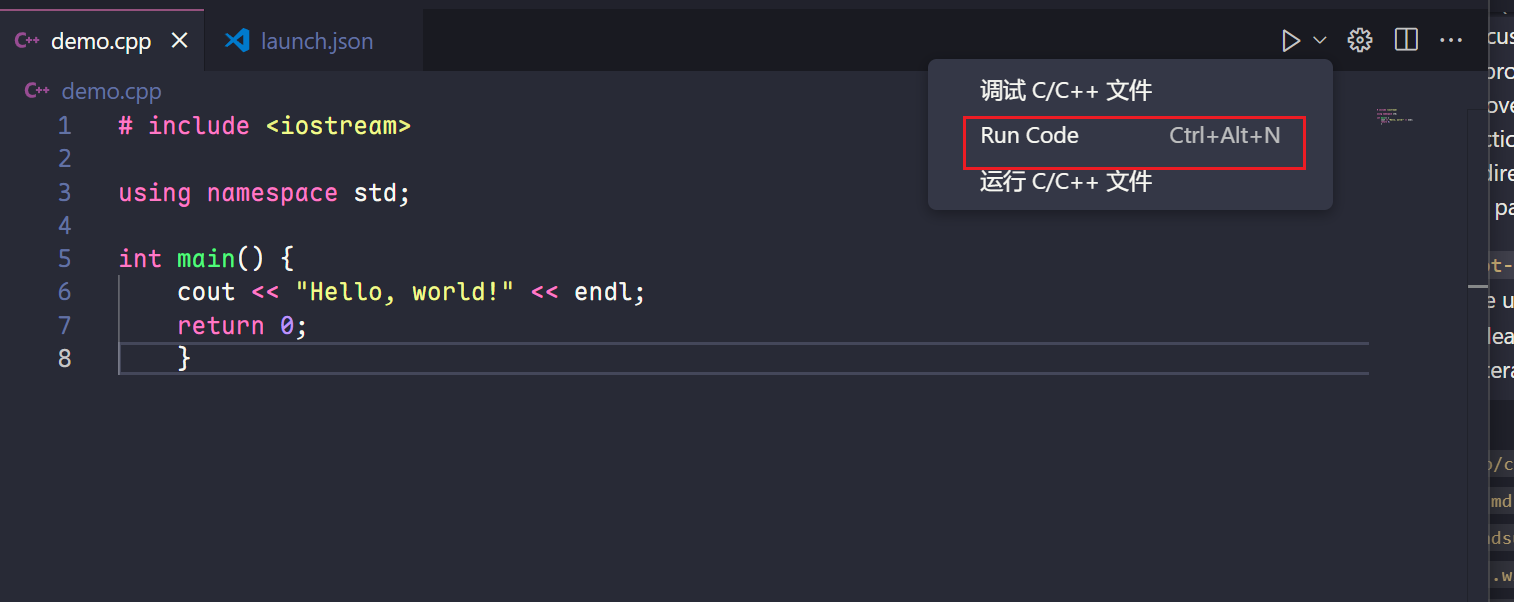
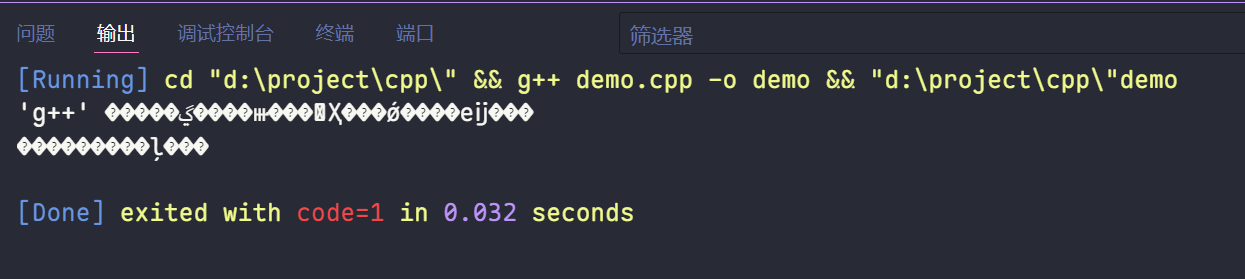
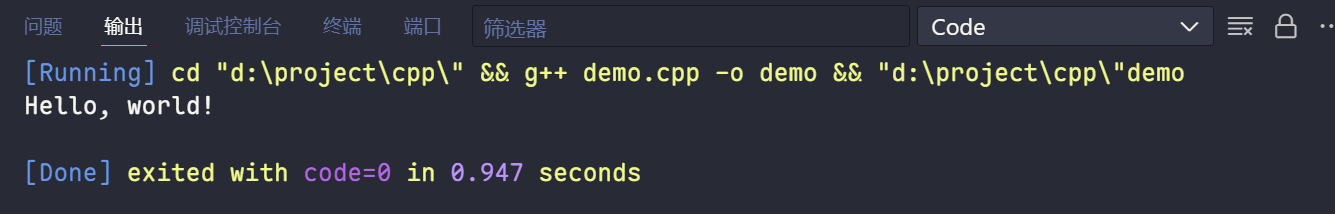
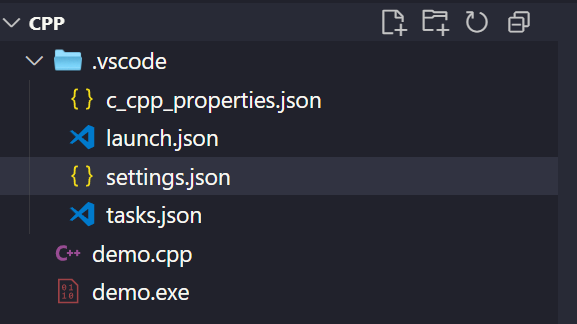
运行完之后会自动生成一个 settings.json。
文件结构:
C++ 常用的编译器:Clang(macos) GCC(Linux) MSVC(微软的 比如 VS 就自带 MSVC)
编译有四个过程(Toolchain):预处理 编译 汇编 链接
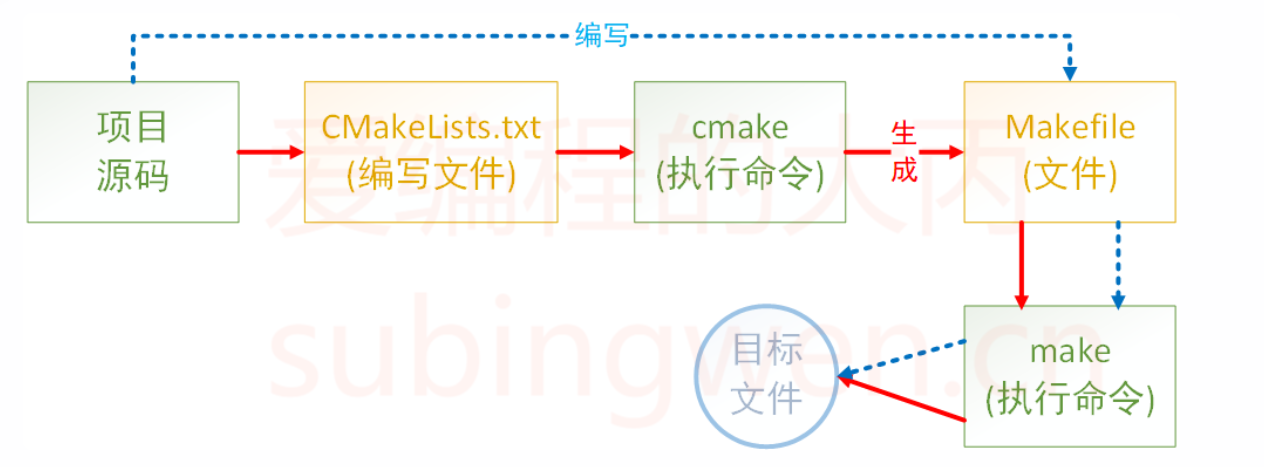
CMake 是构建项目的工具,可以自动生成 Makefile 文件,将源代码变成可执行程序。
main 函数的参数
main 函数有三个参数: argc argv envp
int main(int argc,char *argv[],char *envp[])//char* argv[]等价于char** argv
{
    return 0;
}
//第三个参数一般省略
//argc:程序参数的个数,注意包含程序本身
//argv:这是一个数组,存放每个参数的值。argv[0]即程序本身。
//envp:存放环境变量,数组最后一个元素是空。
比如终端输入 g++ main.cpp 3 2 。那么 argc=3 argv[1] = 3 argv[2] = 2
gdb 调试
apt -y install gdb
如果希望程序可调试,编译时需要加 - g 选项,并且,不能使用 - O 的优化选项。
gdb 可执行文件
| 命令 | 简写 | 命令说明 |
|---|---|---|
| set args | 设置程序运行的参数。 例如:./demo 张三 西施 我是一只傻傻鸟 设置参数的方法是: set args 张三 西施 我是一只傻傻鸟 | |
| break | b | 设置断点,b 20 表示在第 20 行设置断点,可以设置多个断点。 |
| run | r | 开始运行程序,程序运行到断点的位置会停下来,如果没有遇到断点,程序一直运行下去。 |
| next | n | 执行当前行语句,如果该语句为函数调用,不会进入函数内部。 VS 的 F10 |
| step | s | 执行当前行语句,如果该语句为函数调用,则进入函数内部。VS 的 F11 注意了,如果函数是库函数或第三方提供的函数,用 s 也是进不去的,因为没有源代码,如果是自定义的函数,只要有源码就可以进去。 |
| p | 显示变量或表达式的值,如果 p 后面是表达式,会执行这个表达式。 | |
| continue | c | 继续运行程序,遇到下一个断点停止,如果没有遇到断点,程序将一直运行。 VS 的 F5 |
| set var | 设置变量的值。 假设程序中定义了两个变量: int ii; char name [21]; set var ii=10 把 ii 的值设置为 10; set var name="西施"。 | |
| quit | q | 退出 gdb。 |
用 gdb 调试核心文件:
调试 core 文件的步骤如下:
1)用 ulimit -a 查看当前用户的资源限制参数;
2)用 ulimit -c unlimited 把 core file size 改为 unlimited;
3)运行程序,产生 core 文件;
4)运行 gdb 程序名 core 文件名;
5)在 gdb 中,用 bt 查看函数调用栈。
用 gdb 调试正在运行中的程序:
gdb 程序名 -p 进程编号 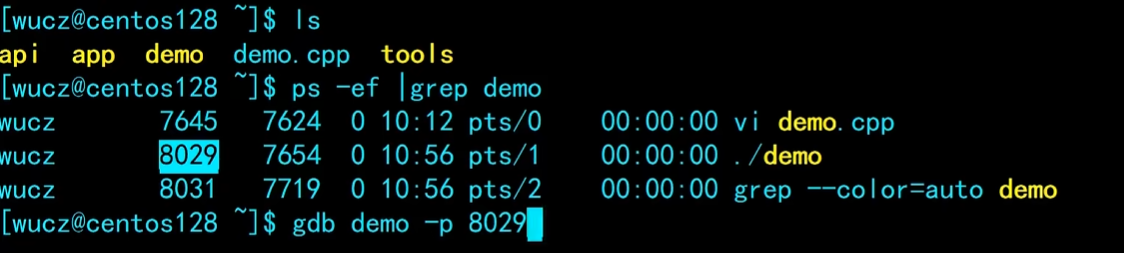
基础语法
变量
数据类型
C 风格的字符串:
C++ 的 string 是一个类,封装了 C 风格的字符串。
C 语言约定:如果字符型(char)数组的末尾包含了空字符 \0(也就是 0),那么该数组中的内容就是一个字符串。
因为字符串需要用 0 结尾,所以在声明字符数组的时候,要预留多一个字节用来存放 0。 char name[21]; // 声明一个最多存放20个英文字符或十个中文的字符串。
- C 风格字符串初始化:
char name[11] = "hello"; // 初始内容为hello,系统会自动添加0。 char name[11] = { 0 }; //把全部的元素初始化为0。
字符串的一些操作函数:
清空字符串: memset(name,0,sizeof(name)); // 把全部的元素置为0
赋值字符串: char* strcpy(char* dest, const char* src) ;
功 能:将参数 src 字符串拷贝至参数 dest 所指的地址。
返回值:返回参数 dest 的字符串起始地址。
复制完字符串后,会在 dest 后追加 0。
如果目标字符串的内存空间不够大,会导致数组的越界。
赋值字符串的另一个函数: char * strncpy(char* dest,const char* src, const size_t n)
功能:把 src 前 n 个字符的内容复制到 dest 中。
返回值:dest 字符串起始地址。
如果 src 字符串长度小于 n,则拷贝完字符串后,在 dest 后追加 0,直到 n 个。
如果 src 的长度大于等于 n,就截取 src 的前 n 个字符,不会在 dest 后追加 0。
如果目标字符串所指的内存空间不够大,会导致数组的越界。
获取字符串长度: size_t strlen( const char* str);
strlen () 函数计算的是字符串的实际长度,遇到 0 结束。
字符串拼接: char* strcat(char* dest,const char* src);
功能:将 src 字符串拼接到 dest 所指的字符串尾部。
返回值:返回 dest 字符串起始地址。
dest 最后原有的结尾字符 0 会被覆盖掉,并在连接后的字符串的尾部再增加一个 0。
字符串拼接的另一个函数: char *strncat (char* dest,const char* src, const size_t n);
功能:将 src 字符串的前 n 个字符拼接到 dest 所指的字符串尾部。
返回值:返回 dest 字符串的起始地址。
如果 n 大于等于字符串 src 的长度,那么将 src 全部追加到 dest 的尾部,如果 n 小于字符串 src 的长度,只追加 src 的前 n 个字符。
strncat 会将 dest 字符串最后的 0 覆盖掉,字符追加完成后,再追加 0。
字符串比较: int strcmp(const char *str1, const char *str2 );
功能:比较 str1 和 str2 的大小。
返回值:相等返回 0,str1 大于 str2 返回 1,str1 小于 str2 返回 - 1;
字符串比较的另一个函数: int strncmp(const char *str1,const char *str2 ,const size_t n)
功能:比较 str1 和 str2 前 n 个字符的大小。
返回值:相等返回 0,str1 大于 str2 返回 1,str1 小于 str2 返回 - 1;
两个字符串比较的方法是比较字符的 ASCII 码的大小,从两个字符串的第一个字符开始,如果分不出大小,就比较第二个字符,如果全部的字符都分不出大小,就返回 0,表示两个字符串相等。
实际开发中只关心字符串是否相等,不关心谁大。
查找字符: const char *strchr(const char *s, int c);
返回在字符串 s 中第一次出现 c 的位置,如果找不到,返回 0。
const char *strrchr(const char *s, int c);
返回在字符串 s 中最后一次出现 c 的位置,如果找不到,返回 0。
查找字符串: char *strstr(const char* str,const char* substr);
功能:检索子串在字符串中首次出现的位置。
返回值:返回字符串 str 中第一次出现子串 substr 的地址;如果没有检索到子串,则返回 0。
一些注意事项:
字符串的结尾标志是 0,按照约定,在处理字符串的时候,会从起始位置开始搜索 0,一直找下去,找到为止(不会判断数组是否越界)。
结尾标志 0 后面的都是垃圾内容。
字符串在每次使用前都要初始化,减少入坑的可能,是每次,不是第一次。
不要在函数中对字符指针用 sizeof 运算,因为得到的是指针的大小。所以,不能在函数中对传入的字符串用 memset 函数进行初始化,除非字符串的长度也作为参数传入到了函数中。
运算符
选择结构
循环结构
函数
回调函数
回调函数简单来说就是把函数 A 作为参数传给函数 B,在未来某一时刻函数 B 调用了函数 A,那么就称函数 A 是回调函数。
传参的方式指的就是函数指针。
函数指针的语法:
假设某个函数的原型是 int func1(int bh,string str); 则函数指针的声明: int (*ptr)(int,string) 。这里的形参名可以写,可以不写。赋值: ptr = func1 。
使用函数指针: ptr(3,"nihao"); 。C 风格调用函数指针的方法: (*ptr)(3,"nihao");
回调函数的示例:
#include <iostream>         // 包含头文件。
using namespace std;        // 指定缺省的命名空间。

void zs(int a)         // 张三的个性化表白函数。
{
	cout  <<"a=" << a << "我要先翻三个跟斗再表白。\n";   // 个性化表白的代码。
}

void ls(int a)         // 李四的个性化表白函数。
{
	cout << "a=" << a << "我有一只小小鸟。\n";   // 个性化表白的代码。
}

void show(void (*pf)(int),int b)//把实参从外面传进去
{
	cout << "表白之前的准备工作已完成。\n";       // 表白之前的准备工作。
	pf(b);                                                                     // 用函数指针名调用个性化表白函数。
	cout << "表白之后的收尾工作已完成。\n";       // 表白之后的收尾工作。
}
//////////////////////////////////
void show(void (*pf)(int))
{
	cout << "表白之前的准备工作已完成。\n";       // 表白之前的准备工作。
    int b = 3;//由调用者函数提供实参
	pf(b);                                                                     // 用函数指针名调用个性化表白函数。
	cout << "表白之后的收尾工作已完成。\n";       // 表白之后的收尾工作。
}
int main()
{
	show(zs);          // 张三要表白。
	show(ls);          // 李四要表白。
}
////////////////////////////////////

int main()
{
	show(zs, 3);          // 张三要表白。
	show(ls, 4);          // 李四要表白。
}
//如何给回调函数传递实参
// *由调用者函数提供实参
// *从外面传进去实参
静态变量
| 全局变量 | 静态全局变量 | 静态局部变量 |
|---|---|---|
| 整个工程,其他文件可以通过 extern 关键字来使用该变量 | 当前文件 | 函数作用域 |
| 静态存储区 | 静态存储区 | 静态存储区 |
| 程序运行期间一直存在 | 程序运行期间一直存在 | 程序运行期间一直存在 |
局部变量和静态局部变量的区别:静态局部变量不会随着函数调用完成而销毁,会保留其值。静态局部变量也是局部变量,在函数外面是访问不到的。
看下面的代码示例:
void func() {
    static int num = 10; // 名字 'num' 只在 func 内部有效
}

int main() {
    // num = 20;  // ❌ 编译错误!main 函数不认识 'num'
    // func::num = 20; // ❌ 也不行,C++ 没有这种语法
    return 0;
}实际上,由于静态局部变量只要程序还在运行,这个变量的内存地址就一直是有效的,数据一直都在那里,只是名字被隐藏了。既然内存还在,只要我们能把这个变量的地址从函数里 “偷” 出来,外部就可以随意读写它!
#include <iostream>

// 这个函数返回静态局部变量的指针(地址)
int* get_static_addr() {
    static int count = 10;
    std::cout << "函数内部: " << count << std::endl;
    return &count; // ✅ 合法!因为 count 在函数结束后内存不会被销毁
}

int main() {
    // 1. 获取地址
    int* ptr = get_static_addr();

    // 2. 在外部修改它
    *ptr = 999;
    std::cout << "在 main 函数中修改了变量..." << std::endl;

    // 3. 再次调用函数验证
    get_static_addr(); // 输出将是 999,证明修改成功!

    return 0;
}
函数重载
函数重写
指针
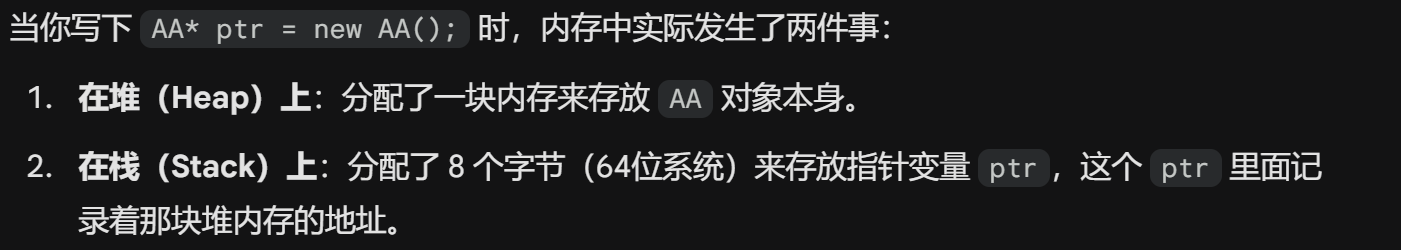
new 和 delete 运算符
函数指针
函数指针就是指向函数的指针。基本语法如下:
int demo(int a, int b)
{


}

int newptr = (*ptr)(int,int)
//可以用auto关键字简化:
auto newptr = demo;
顶层 const 和底层 const
顶层:变量本身是个常量。比如: int* const p1 ,const 紧挨着 p1,说明 p1 自身不可变,这就是顶层 const。
底层:通常只和指针和引用有关。指针 / 引用指向 / 绑定的那个对象是常量。(说的是在指针 / 引用眼里那个对象是常量,也就是不能用指针 / 引用修改对象的值。)
一个指针可以同时具有顶层 const 和底层 const。
int i = 0;
const int* const p3 = &i;
为什么要区分顶层和底层 const?
规则 A:拷贝时,顶层 const 会被无视,底层 const 必须严格匹配!
当你把一个变量赋值给另一个变量时,变量本身是不是常量根本不重要(因为你是把值拷走,又不是修改原来的变量)。但底层 const 关系到访问权限,编译器会严格检查。 原则是:你可以把【非底层 const】拷贝给【底层 const】 但绝对不能把【底层 const】拷贝给【非底层 const】
规则 B:使用 auto 推导类型时,顶层 const 会被丢弃。
如果你用 auto 让编译器猜类型,它会忽略顶层 const,但保留底层 const。
区分指针常量和常量指针。
指针常量:这个常量是一个指针,表示指针的内容不能改变,也就是存储的地址不能改变。
常量指针:指向常量的指针,表示不能通过指针来修改指向对象的值。指针本身的内容可以修改。
数组
引用
枚举
枚举是一种创建符号常量的方法。
创建常量有很多种方法:define const 枚举 constexpr 等等。
所谓的常量就是初始化后不可修改的变量或者字面量(写在代码里的固定值)
constexpr:constexpr 用于定义编译期常量。它不仅意味着值不能被修改,还保证了这个值在程序编译阶段就已经确定了。
const:const 用于定义运行期只读变量或编译期常量。一旦被初始化,它的值就不能再被改变。const 变量的值可以在运行期才计算出来,但一旦赋值就不准再改了;而 constexpr 必须在编译期就能算出来。
比如:int userInput; std::cin >> userInput; const int RUNTIME_CONST = userInput * 2;
RUNTIME_CONST 只有在运行期用户输入值的时候才能确认下来。
字面量:int a = 42; // 42 是整型字面量常量 const char* s = "Hi"; // "Hi" 是字符串字面量常量 (储存在只读数据段)
语法: enum 枚举名 { 枚举量1 , 枚举量2 , 枚举量3, ......, 枚举量n }
enum colors { red , yellow , blue };
这条语句完成了两项工作:
让 colors 成了一种新的枚举类型的名称,可以用它创建枚举变量。
colors col = red.将 red、yellow、blue 作为符号常量,默认值是 0、1、2。
C++11 标准:
// 现代做法:强类型枚举 (C++11)
enum class ErrorCode {
    SUCCESS = 0,
    NOT_FOUND = 404,
    SERVER_ERROR = 500
};
ErrorCode status = ErrorCode::SUCCESS; // 必须带作用域前缀

// 传统做法:C语言风格枚举(不推荐,容易名字冲突)
enum Color { RED, GREEN, BLUE };
Color myColor = RED;
命名空间
1 内存分区模型
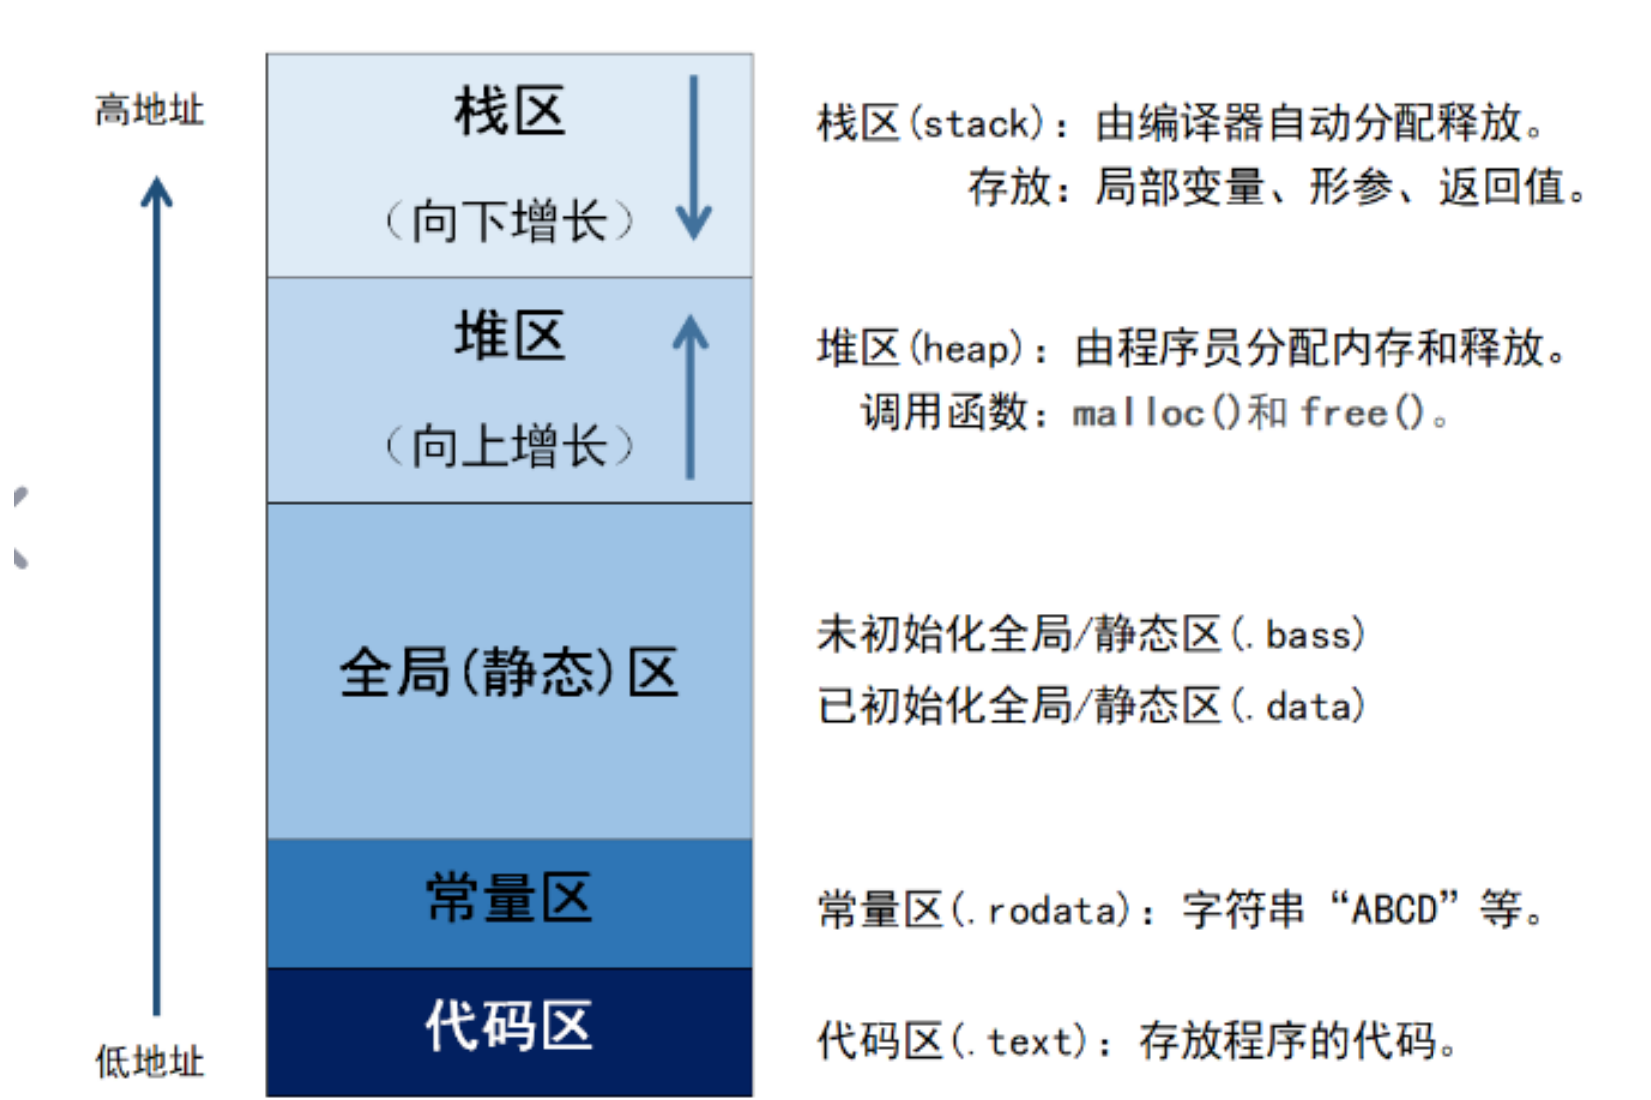
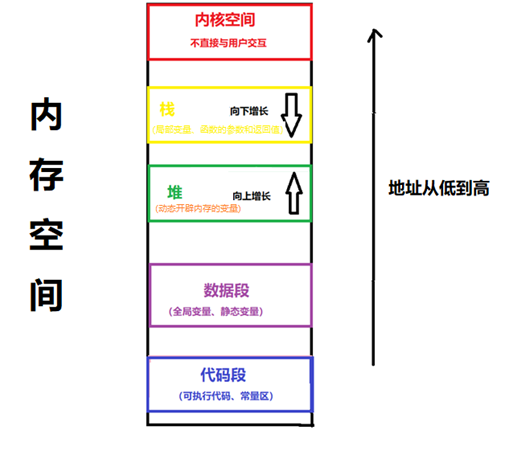
C++ 程序在执行时,将内存大方向划分为 4 个区域
- 代码区:存放函数体的二进制代码,由操作系统进行管理的
- 全局区:存放全局变量和静态变量以及常量
- 栈区:由编译器自动分配释放,存放函数的参数值,局部变量等
- 堆区:由程序员分配和释放,若程序员不释放,程序结束时由操作系统回收
栈和堆的主要区别:
管理方式不同:栈是系统自动管理的,在出作用域时,将自动被释放;堆需手动释放,若程序中不释放,程序结束时由操作系统回收。
空间大小不同:堆内存的大小受限于物理内存空间;而栈就小得可怜,一般只有 8M(可以修改系统参数)。
3)分配方式不同:堆是动态分配;栈有静态分配和动态分配(都是自动释放)。
4)分配效率不同:栈是系统提供的数据结构,计算机在底层提供了对栈的支持,进栈和出栈有专门的指令,效率比较高;堆是由 C++ 函数库提供的。
5)是否产生碎片:对于栈来说,进栈和出栈都有着严格的顺序(先进后出),不会产生碎片;而堆频繁的分配和释放,会造成内存空间的不连续,容易产生碎片,太多的碎片会导致性能的下降。
6)增长方向不同:栈向下增长,以降序分配内存地址;堆向上增长,以升序分配内存地址。
1.1 程序运行前
在程序编译后,生成了 exe 可执行程序,未执行该程序前分为两个区域
代码区:
存放 CPU 执行的机器指令
代码区是共享的,共享的目的是对于频繁被执行的程序,只需要在内存中有一份代码即可
代码区是只读的,使其只读的原因是防止程序意外地修改了它的指令
全局区:
全局变量和静态变量存放在此.
全局区还包含了常量区,字符串常量和其他常量也存放在此.
该区域的数据在程序结束后由操作系统释放.
示例:
//全局变量
int g_a = 10;
int g_b = 10;

//全局常量
const int c_g_a = 10;
const int c_g_b = 10;

int main() {

	//局部变量
	int a = 10;
	int b = 10;

	//打印地址
	cout << "局部变量a地址为: " << (int)&a << endl;
	cout << "局部变量b地址为: " << (int)&b << endl;

	cout << "全局变量g_a地址为: " <<  (int)&g_a << endl;
	cout << "全局变量g_b地址为: " <<  (int)&g_b << endl;

	//静态变量
	static int s_a = 10;
	static int s_b = 10;

	cout << "静态变量s_a地址为: " << (int)&s_a << endl;
	cout << "静态变量s_b地址为: " << (int)&s_b << endl;

	cout << "字符串常量地址为: " << (int)&"hello world" << endl;
	cout << "字符串常量地址为: " << (int)&"hello world1" << endl;

	cout << "全局常量c_g_a地址为: " << (int)&c_g_a << endl;
	cout << "全局常量c_g_b地址为: " << (int)&c_g_b << endl;

	const int c_l_a = 10;
	const int c_l_b = 10;
	cout << "局部常量c_l_a地址为: " << (int)&c_l_a << endl;
	cout << "局部常量c_l_b地址为: " << (int)&c_l_b << endl;

	system("pause");

	return 0;
}
打印结果:
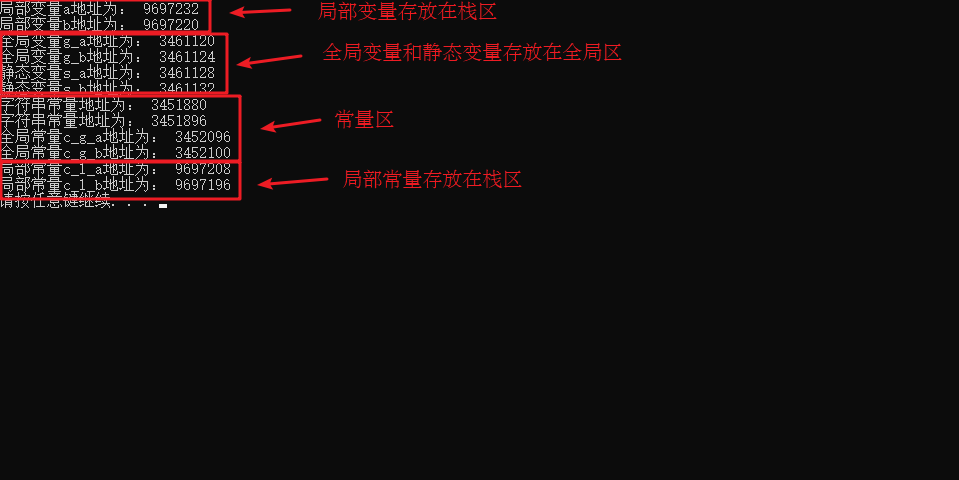
总结:
- C++ 中在程序运行前分为全局区和代码区
- 代码区特点是共享和只读
- 全局区中存放全局变量、静态变量、常量
- 常量区中存放 const 修饰的全局常量 和 字符串常量
1.2 程序运行后
栈区:
由编译器自动分配释放,存放函数的参数值,局部变量等
注意事项:不要返回局部变量的地址,栈区开辟的数据由编译器自动释放
示例:
int * func()
{
	int a = 10;
	return &a;
}

int main() {

	int *p = func();

	cout << *p << endl;
	cout << *p << endl;

	system("pause");

	return 0;
} 堆区:
由程序员分配释放,若程序员不释放,程序结束时由操作系统回收
在 C++ 中主要利用 new 在堆区开辟内存
示例:
int* func()
{
	int* a = new int(10);
	return a;
}

int main() {
	int *p = func();
	cout << *p << endl;
	cout << *p << endl;
	system("pause");
	return 0;
}
总结:
堆区数据由程序员管理开辟和释放
堆区数据利用 new 关键字进行开辟内存
1.3 new 操作符
C++ 中利用 new 操作符在堆区开辟数据
堆区开辟的数据,由程序员手动开辟,手动释放,释放利用操作符 delete
语法: new 数据类型
利用 new 创建的数据,会返回该数据对应的类型的指针
注意:区分 new 和 malloc 函数
示例 1: 基本语法
int* func()
{
	int* a = new int(10);
	return a;
}

int main() {

	int *p = func();

	cout << *p << endl;
	cout << *p << endl;

	//利用delete释放堆区数据
	delete p;

	//cout << *p << endl; //报错,释放的空间不可访问

	system("pause");

	return 0;
}
示例 2:开辟数组
//堆区开辟数组
int main() {

	int* arr = new int[10];

	for (int i = 0; i < 10; i++)
	{
		arr[i] = i + 100;
	}

	for (int i = 0; i < 10; i++)
	{
		cout << arr[i] << endl;
	}
	//释放数组 delete 后加 []
	delete[] arr;

	system("pause");

	return 0;
}
配对原则:在 C++ 中,new 和 delete 必须严格配对。
- 如果你用 new 申请单个对象,就用 delete 释放。
- 如果你用 new type [] 申请数组,就必须用 delete [] 释放。
2 引用
2.1 引用的基本使用
** 作用: ** 给变量起别名
语法: 数据类型 &别名 = 原名
2.2 引用注意事项
- 引用必须初始化
- 引用在初始化后,不可以改变
示例:
int main() {

	int a = 10;
	int b = 20;
	//int &c; //错误,引用必须初始化
	int &c = a; //一旦初始化后,就不可以更改
	c = b; //这是赋值操作,不是更改引用

	cout << "a = " << a << endl;
	cout << "b = " << b << endl;
	cout << "c = " << c << endl;

	system("pause");

	return 0;
}
2.3 引用做函数参数
** 作用:** 函数传参时,可以利用引用的技术让形参修饰实参
** 优点:** 可以简化指针修改实参
示例:
//1. 值传递
void mySwap01(int a, int b) {
	int temp = a;
	a = b;
	b = temp;
}

//2. 地址传递
void mySwap02(int* a, int* b) {
	int temp = *a;
	*a = *b;
	*b = temp;
}

//3. 引用传递
void mySwap03(int& a, int& b) {
	int temp = a;
	a = b;
	b = temp;
}

int main() {

	int a = 10;
	int b = 20;

	mySwap01(a, b);
	cout << "a:" << a << " b:" << b << endl;

	mySwap02(&a, &b);
	cout << "a:" << a << " b:" << b << endl;

	mySwap03(a, b);
	cout << "a:" << a << " b:" << b << endl;

	system("pause");

	return 0;
}
总结:通过引用参数产生的效果同按地址传递是一样的。引用的语法更清楚简单
2.4 引用做函数返回值
作用:引用是可以作为函数的返回值存在的
注意:不要返回局部变量引用
用法:函数调用作为左值
示例:
//返回局部变量引用
int& test01() {
	int a = 10; //局部变量
	return a;
}

//返回静态变量引用
int& test02() {
	static int a = 20;
	return a;
}

int main() {

	//不能返回局部变量的引用
	int& ref = test01();
	cout << "ref = " << ref << endl;
	cout << "ref = " << ref << endl;

	//如果函数做左值,那么必须返回引用
	int& ref2 = test02();
	cout << "ref2 = " << ref2 << endl;
	cout << "ref2 = " << ref2 << endl;

	test02() = 1000;

	cout << "ref2 = " << ref2 << endl;
	cout << "ref2 = " << ref2 << endl;

	system("pause");

	return 0;
}
2.5 引用的本质
本质:引用的本质在 c++ 内部实现是一个指针常量.
指针常量:这个指针指向的变量是固定的。
讲解示例:
//发现是引用,转换为 int* const ref = &a;
void func(int& ref){
	ref = 100; // ref是引用,转换为*ref = 100
}
int main(){
	int a = 10;

    //自动转换为 int* const ref = &a; 指针常量是指针指向不可改,也说明为什么引用不可更改
	int& ref = a;
	ref = 20; //内部发现ref是引用,自动帮我们转换为: *ref = 20;

	cout << "a:" << a << endl;
	cout << "ref:" << ref << endl;

	func(a);
	return 0;
}
结论:C++ 推荐用引用技术,因为语法方便,引用本质是指针常量,但是所有的指针操作编译器都帮我们做了
2.6 常量引用
作用: 常量引用主要用来修饰形参,防止误操作
在函数形参列表中,可以加 const 修饰形参,防止形参改变实参
示例:
//引用使用的场景,通常用来修饰形参
void showValue(const int& v) {
	//v += 10;
	cout << v << endl;
}

int main() {

	//int& ref = 10;  引用本身需要一个合法的内存空间,因此这行错误
	//加入const就可以了,编译器优化代码,int temp = 10; const int& ref = temp;
	const int& ref = 10;

	//ref = 100;  //加入const后不可以修改变量
	cout << ref << endl;

	//函数中利用常量引用防止误操作修改实参
	int a = 10;
	showValue(a);

	system("pause");

	return 0;
}
3 函数提高
3.1 函数默认参数
在 C++ 中,函数的形参列表中的形参是可以有默认值的。
语法: 返回值类型 函数名 (参数= 默认值){}
示例:
int func(int a, int b = 10, int c = 10) {
	return a + b + c;
}

//1. 如果某个位置参数有默认值,那么从这个位置往后,从左向右,必须都要有默认值
//2. 如果函数声明有默认值,函数实现的时候就不能有默认参数
int func2(int a = 10, int b = 10);
int func2(int a, int b) {
	return a + b;
}

int main() {

	cout << "ret = " << func(20, 20) << endl;
	cout << "ret = " << func(100) << endl;

	system("pause");

	return 0;
}
3.2 函数占位参数
C++ 中函数的形参列表里可以有占位参数,用来做占位,调用函数时必须填补该位置
语法: 返回值类型 函数名 (数据类型){}
在现阶段函数的占位参数存在意义不大,但是后面的课程中会用到该技术
示例:
//函数占位参数 ,占位参数也可以有默认参数
void func(int a, int) {
	cout << "this is func" << endl;
}

int main() {

	func(10,10); //占位参数必须填补

	system("pause");

	return 0;
}
3.3 函数重载
3.3.1 函数重载概述
** 作用:** 函数名可以相同,提高复用性
函数重载满足条件:
- 同一个作用域下
- 函数名称相同
- 函数参数类型不同 或者 个数不同 或者 顺序不同
注意: 函数的返回值不可以作为函数重载的条件
示例:
//函数重载需要函数都在同一个作用域下
void func()
{
	cout << "func 的调用!" << endl;
}
void func(int a)
{
	cout << "func (int a) 的调用!" << endl;
}
void func(double a)
{
	cout << "func (double a)的调用!" << endl;
}
void func(int a ,double b)
{
	cout << "func (int a ,double b) 的调用!" << endl;
}
void func(double a ,int b)
{
	cout << "func (double a ,int b)的调用!" << endl;
}

//函数返回值不可以作为函数重载条件
//int func(double a, int b)
//{
//	cout << "func (double a ,int b)的调用!" << endl;
//}


int main() {

	func();
	func(10);
	func(3.14);
	func(10,3.14);
	func(3.14 , 10);

	system("pause");

	return 0;
}
3.3.2 函数重载注意事项
- 引用作为重载条件
- 函数重载碰到函数默认参数
示例:
//函数重载注意事项
//1、引用作为重载条件

void func(int &a)
{
	cout << "func (int &a) 调用 " << endl;
}

void func(const int &a)
{
	cout << "func (const int &a) 调用 " << endl;
}


//2、函数重载碰到函数默认参数

void func2(int a, int b = 10)
{
	cout << "func2(int a, int b = 10) 调用" << endl;
}

void func2(int a)
{
	cout << "func2(int a) 调用" << endl;
}

int main() {

	int a = 10;
	func(a); //调用无const
	func(10);//调用有const


	//func2(10); //碰到默认参数产生歧义,需要避免

	system("pause");

	return 0;
}
编译
C++ 的编译有四部分:预处理、编译、汇编、链接。
汇编完之后得到 obj 类型文件(windows 系统)或.o 类型文件(Linux 系统):二进制目标文件
只有源文件才能编译、头文件不可以。
链接:编译后的目标文件和他们所需要的库文件(lib)链接在一起 得到可执行文件。
编译模式:通常,在一个 C++ 程序中,只包含两类文件 —— .cpp 文件和 .h 文件。其中,.cpp 文件被称作 C++ 源文件,里面放的都是 C++ 的源代码;而 .h 文件则被称作 C++ 头文件,里面放的也是 C++ 的源代码。
C++ 语言支持 "分别编译"(separatecompilation)。也就是说,一个程序所有的内容,可以分成不同的部分分别放在不同的 .cpp 文件里。.cpp 文件里的东西都是相对独立的,在编译时不需要与其他文件互通,只需要在编译成目标文件后再与其他的目标文件做一次链接(link)就行了。比如,在文件 a.cpp 中定义了一个全局函数 "void a (){}",而在文件 b.cpp 中需要调用这个函数。即使这样,文件 a.cpp 和文件 b.cpp 并不需要相互知道对方的存在,而是可以分别地对它们进行编译,编译成目标文件之后再链接,整个程序就可以运行了。这是如何实现的?文件 b.cpp 中,在调用 "void a ()" 函数之前,先声明一下这个函数 "void a ();",就可以了。这是因为编译器在编译 b.cpp 的时候会生成一个符号表(symbol table),像 "void a ()" 这样的看不到定义的符号,就会被存放在这个表中。再进行链接的时候,编译器就会在别的目标文件中去寻找这个符号的定义。一旦找到了,程序也就可以顺利地生成了。
注意声明和定义的区别,"声明" 则只是声明这个符号的存在,即告诉编译器,这个符号可能是在其他文件中定义的,我这里先用着,你链接的时候再到别的地方去找找看它到底是什么吧。定义的时候要按 C++ 语法完整地定义一个符号(变量或者函数)在整个程序中可以多次声明,但是只能定义一次。
变量如何声明?extern int a; // 这是一个纯粹的【声明】。int b; // 这是声明也是定义
头文件里面放声明 源文件放定义。当然不绝对,头文件中也可以出现定义,具体细节参考:
命名空间
命名空间分割了全局空间,每个命名空间都是一个作用域,用来防止名字冲突。
namespace aa

{
	int b = 0;
 // 类、函数、模板、变量的声明和定义。

}

int main()
{


}
使用命名空间的名字:aa::b
或者 using aa::b; 或者 using namespace aa;
用 using 声明名后,就可以进行直接使用名称。但是如果该声明区域有相同的名字,则会报错。
using namespace 命名空间 将使整个命名空间中的名字可用。如果声明区域有相同的名字,局部版本将隐藏命名空间中的名字,不过,可以使用域名解析符使用命名空间中的名称。
C++ 标准库的命名空间是 std;
std::string_literals string_literals 是 std 的子命名空间
image-20260302162347153
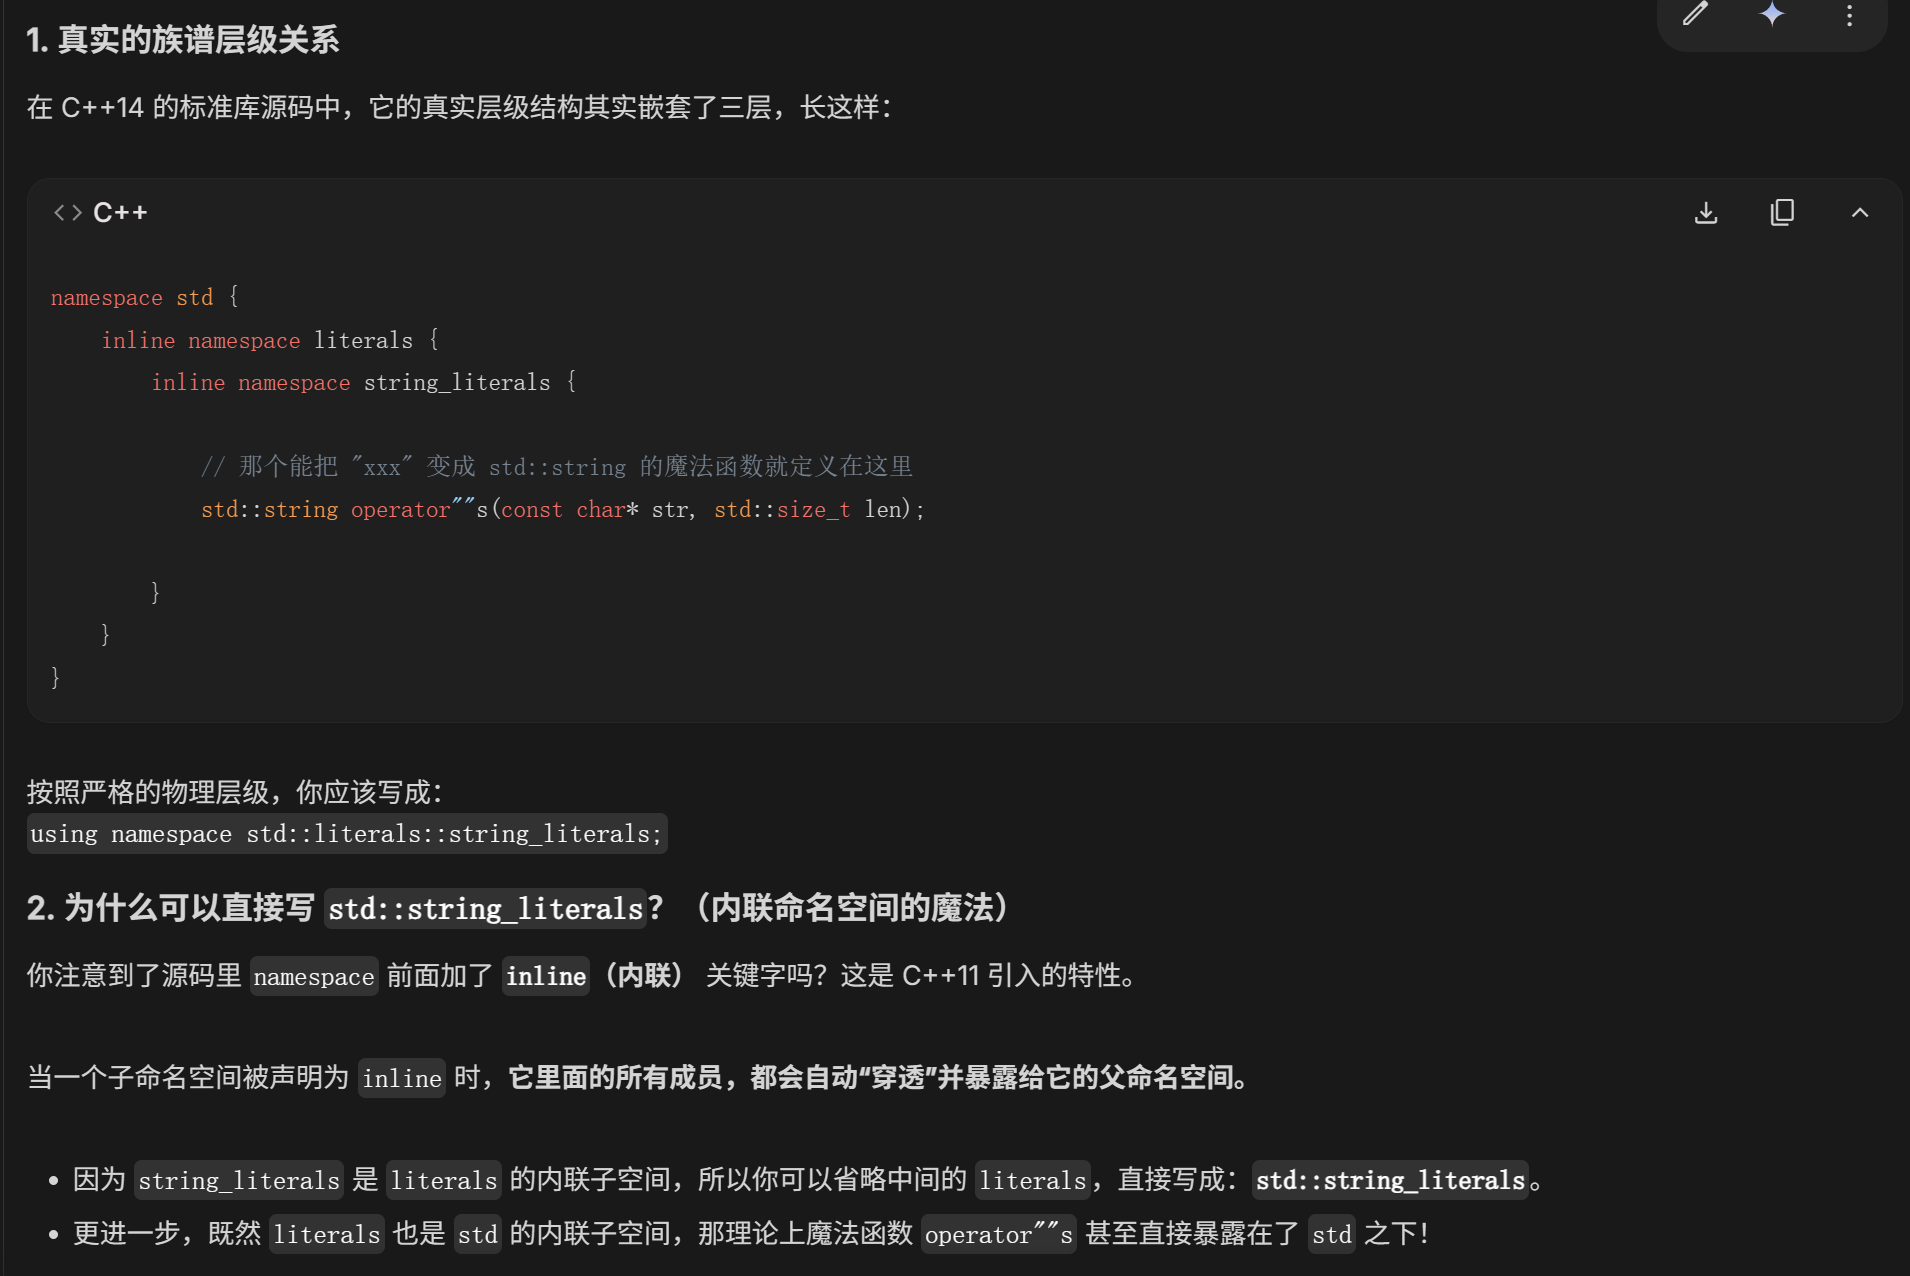
名字空间污染:将过多的标识符(变量名、函数名、类名等)引入到了不该出现的全局作用域或特定的作用域中,大大增加了命名冲突(Name Clashes)的风险。
最常见的污染源就是滥用 using namespace std;。
C++ 标准库(STL)中定义了大量的名字(如 count, data, time, max, min, distance 等)。如果你在全局定义了一个同名变量,编译器就不知道你想使用哪个名字。
#include <iostream>
using namespace std;

// 定义一个全局变量
int cout = 0;

int main() {
    // 💥 编译报错!
    // 编译器不知道这里的 cout 是指你的全局 int 变量,还是 std::cout 函数
    cout << count << endl;
    return 0;
}
内存对齐
计算机在存储数据的时候为了方便 CPU 快速的读取数据,在数据之间留了一些空隙。不按照字节顺序一个挨一个排放,而是按照特定倍数的地址(如 4 的倍数、8 的倍数)来排放数据的机制。
CPU 读取数据不是按照字节一个个读取的,是以内存存取粒度为单位进行读取的。
32 位系统 CPU 的内存存取粒度是 4 字节。该处理器只能从地址为 4 的倍数的内存开始读取数据。32 位系统中 int 是 4 字节,char 是 1 字节。
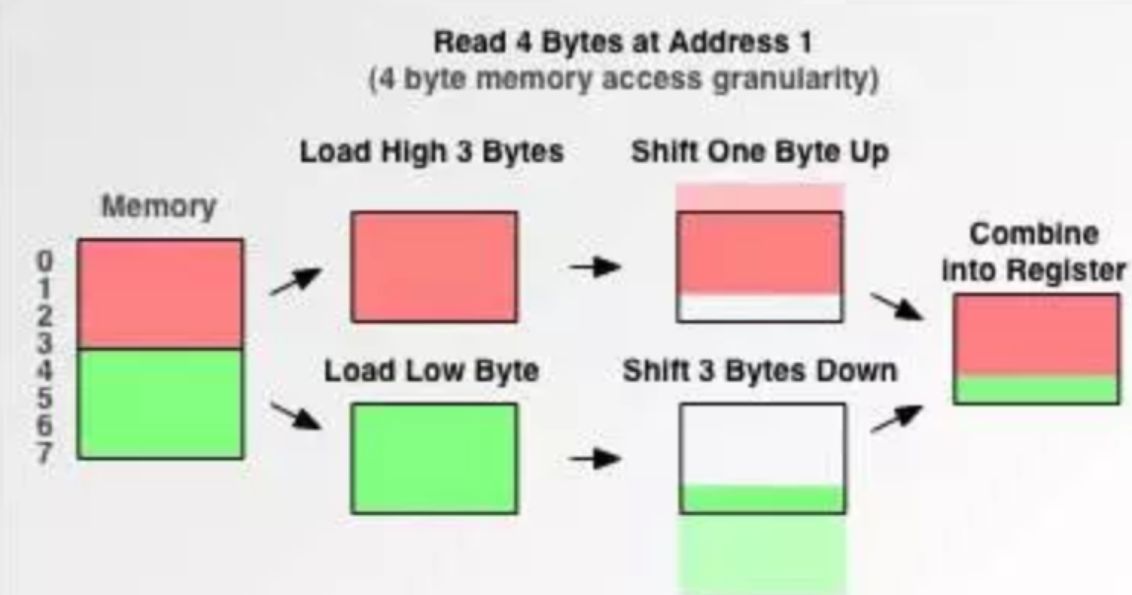
在 Linux 系统下,可以通过预编译命令 #pragma pack(n) ,n = 1,2,4,8,16 来改变对齐系数。gcc 默认对齐系数是 4
对齐单位:是给定值 #pragma pack(n) 和结构体中最长数据类型长度中较小的那个。
对齐规则:
- 结构体第一个成员的偏移量(offset)为 0,以后每个成员相对于结构体首地址的 offset 都是该成员大小与对齐单位中较小那个的整数倍,如有需要编译器会在成员之间加上填充字节。
- 结构体的总大小为对齐单位的整数倍,如有需要编译器会在最末一个成员之后加上填充字节。
左值右值
判断左值和右值的区别
左值:有确定的内存地址、可反复使用
右值:1. 没有身份的临时结果,比如字面量、函数按值返回的对象 2. 将亡值:有身份但是即将销毁
静态库和动态库
库:就是把函数和类打包在一起称为库。
库分为静态库和动态库。
编译的过程:预处理 - 编译 - 汇编 - 链接
静态库:程序在编译时会把库文件的二进制代码链接到目标程序中,这种方式称为静态链接。
如果多个程序中用到了同一静态库中的函数或类,就会存在多份拷贝。
程序的更新和发布不方便,如果某一个静态库更新了,所有使用它的程序都需要重新编译。
//制作静态库
g++ -c -o lib库名.a 库代码文件

//使用静态库
g++ 选项 源代码文件 -L库文件所在目录 -l库名
动态库:程序在编译时不会把库文件的二进制代码链接到目标程序中,而是在运行时候才被载入。
如果多个进程中用到了同一动态库中的函数或类,那么在内存中只有一份,避免了空间浪费问题。
程序升级比较简单,不需要重新编译程序,只需要更新动态库就行了。
可以实现进程之间的代码共享,因此动态库也称为共享库。
//制作动态库
g++ -fPIC -shared -o lib库名.so 库代码文件

//使用动态库
g++ 选项 源代码文件 -L库文件所在目录 -l库名
//运行可执行程序前,需要设置LD_LIBRARY_PATH环境变量
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:库文件所在目录
内存泄漏:在堆上动态分配了一块内存,用一个指针指向这块内存。后来这个指针被销毁了,但是因为一些原因内存没有释放,这就叫内存泄漏。