面向对象编程
面向对象编程
本阶段主要针对 C++ 面向对象编程技术做详细讲解,涉及到面向对象的三大特性:封装、继承、多态。
类和对象
C++ 面向对象的三大特性为:封装、继承、多态
C++ 认为万事万物都皆为对象,对象上有其属性和行为
4.1 封装
4.1.1 封装的意义
封装是 C++ 面向对象三大特性之一
封装的意义:
- 将属性和行为作为一个整体,表现生活中的事物
- 将属性和行为加以权限控制
封装意义一:
在设计类的时候,属性和行为写在一起,表现事物
语法: class 类名{ 访问权限: 属性 / 行为 };
示例 1: 设计一个圆类,求圆的周长
示例代码:
//圆周率
const double PI = 3.14;

//1、封装的意义
//将属性和行为作为一个整体,用来表现生活中的事物

//封装一个圆类,求圆的周长
//class代表设计一个类,后面跟着的是类名
class Circle
{
public:  //访问权限  公共的权限

	//属性
	int m_r;//半径

	//行为
	//获取到圆的周长
	double calculateZC()
	{
		//2 * pi  * r
		//获取圆的周长
		return  2 * PI * m_r;
	}
};

int main() {

	//通过圆类,创建圆的对象
	// c1就是一个具体的圆
	Circle c1;
	c1.m_r = 10; //给圆对象的半径 进行赋值操作

	//2 * pi * 10 = = 62.8
	cout << "圆的周长为: " << c1.calculateZC() << endl;

	system("pause");

	return 0;
}
封装意义二:
类在设计时,可以把属性和行为放在不同的权限下,加以控制
访问权限有三种:
- public 公共权限
- protected 保护权限
- private 私有权限
示例:
//三种权限
//公共权限  public     类内可以访问  类外可以访问
//保护权限  protected  类内可以访问  类外不可以访问
//私有权限  private    类内可以访问  类外不可以访问

class Person
{
	//姓名  公共权限
public:
	string m_Name;

	//汽车  保护权限
protected:
	string m_Car;

	//银行卡密码  私有权限
private:
	int m_Password;

public:
	void func()
	{
		m_Name = "张三";
		m_Car = "拖拉机";
		m_Password = 123456;
	}
};

int main() {

	Person p;
	p.m_Name = "李四";
	//p.m_Car = "奔驰";  //保护权限类外访问不到
	//p.m_Password = 123; //私有权限类外访问不到

	system("pause");

	return 0;
}
4.1.2 struct 和 class 区别
在 C++ 中 struct 和 class 唯一的区别就在于 默认的访问权限不同
区别:
- struct 默认权限为公共
- class 默认权限为私有
4.1.3 成员属性设置为私有
优点 1: 将所有成员属性设置为私有,可以自己控制读写权限
优点 2: 对于写权限,我们可以检测数据的有效性
示例:
class Person {
public:

	//姓名设置可读可写
	void setName(string name) {
		m_Name = name;
	}
	string getName()
	{
		return m_Name;
	}


	//获取年龄
	int getAge() {
		return m_Age;
	}
	//设置年龄
	void setAge(int age) {
		if (age < 0 || age > 150) {
			cout << "你个老妖精!" << endl;
			return;
		}
		m_Age = age;
	}

	//情人设置为只写
	void setLover(string lover) {
		m_Lover = lover;
	}

private:
	string m_Name; //可读可写  姓名

	int m_Age; //只读  年龄

	string m_Lover; //只写  情人
};


int main() {

	Person p;
	//姓名设置
	p.setName("张三");
	cout << "姓名: " << p.getName() << endl;

	//年龄设置
	p.setAge(50);
	cout << "年龄: " << p.getAge() << endl;

	//情人设置
	p.setLover("苍井");
	//cout << "情人: " << p.m_Lover << endl;  //只写属性,不可以读取

	system("pause");

	return 0;
}
类中有成员变量和成员函数。变量是属性,函数是方法。
下面介绍下常成员函数: 在函数体花括号前加一个 const 关键字
这个函数要做的事情:
- 这个函数不会修改类里面的非静态成员变量
- 这个函数不会调用其它非 const 的成员函数(非 const 成员函数可能会修改成员变量的值)
思考:为什么要加上 const 关键字,我写程序的时候自己注意点,不进行变量修改不就行了,加 const 多此一举。
为了性能,我们用引用传递对象(避免拷贝)。为了安全,我们在引用前面加 const(防止函数内部乱改对象)。变成 const 对象后,它只能调用带有 const 后缀的常成员函数!所以,只要你的类里的方法是只读的,必须、一定要在后面加上 const,否则别人拿到你这个类的 const 引用时,什么方法都调用不了。
// 假设 Person 类的 getAge() 后面【没有】写 const
void printPersonInfo(const Person& p) {
    // ⚠️ 灾难发生!
    // p 现在是一个 const 对象,它意味着 p 里面的数据被锁死了,绝对不能变。
    // 如果 getAge() 没有标记为 const,编译器会认为:“调用 getAge() 有可能修改 p 的数据!”
    // 于是,编译器为了保护 p,直接禁止你调用 getAge(),编译报错!
    cout << "年龄是: " << p.getAge() << endl; // ❌ 编译错误!
}
凡事都有例外。有时候我们在一个整体上是 “只读” 的函数里,确实需要修改一两个无关紧要的变量(比如:我想记录一下 getAge () 这个函数被调用了多少次)。可以使用关键字:mutable 修饰成员变量,这样在 const 成员函数中可以修改该变量。
对象的初始化和清理
构造函数和析构函数
对象的初始化和清理也是两个非常重要的安全问题
一个对象或者变量没有初始状态,对其使用后果是未知
同样的使用完一个对象或变量,没有及时清理,也会造成一定的安全问题
c++ 利用了构造函数和析构函数解决上述问题,这两个函数将会被编译器自动调用,完成对象初始化和清理工作。
对象的初始化和清理工作是编译器强制要我们做的事情,因此如果我们不提供构造和析构,编译器会提供
编译器提供的构造函数和析构函数是空实现。
- 构造函数:主要作用在于创建对象时为对象的成员属性赋值,构造函数由编译器自动调用,无须手动调用。
- 析构函数:主要作用在于对象销毁前系统自动调用,执行一些清理工作。
构造函数语法: 类名(){}
- 构造函数,没有返回值也不写 void
- 函数名称与类名相同
- 构造函数可以有参数,因此可以发生重载
- 程序在调用对象时候会自动调用构造,无须手动调用,而且只会调用一次
析构函数语法: ~类名(){}
- 析构函数,没有返回值也不写 void
- 函数名称与类名相同,在名称前加上符号~
- 析构函数不可以有参数,因此不可以发生重载
- 程序在对象销毁前会自动调用析构,无须手动调用,而且只会调用一次
class Person
{
public:
	//构造函数
	Person()
	{
		cout << "Person的构造函数调用" << endl;
	}
	//析构函数
	~Person()
	{
		cout << "Person的析构函数调用" << endl;
	}

};

void test01()
{
	Person p;
}

int main() {

	test01();

	system("pause");

	return 0;
}
4.2.2 构造函数的分类及调用
两种分类方式:
按参数分为: 有参构造和无参构造
按类型分为: 普通构造和拷贝构造
三种调用方式:
括号法
显示法
隐式转换法
示例:
//1、构造函数分类
// 按照参数分类分为 有参和无参构造   无参又称为默认构造函数
// 按照类型分类分为 普通构造和拷贝构造

class Person {
public:
	//无参(默认)构造函数
	Person() {
		cout << "无参构造函数!" << endl;
	}
	//有参构造函数
	Person(int a) {
		age = a;
		cout << "有参构造函数!" << endl;
	}
	//拷贝构造函数
	Person(const Person& p) {
		age = p.age;
		cout << "拷贝构造函数!" << endl;
	}
	//析构函数
	~Person() {
		cout << "析构函数!" << endl;
	}
public:
	int age;
};

//2、构造函数的调用
//调用无参构造函数
void test01() {
	Person p; //调用无参构造函数
}

//调用有参的构造函数
void test02() {

	//2.1  括号法,常用
	Person p1(10);
	//注意1:调用无参构造函数不能加括号,如果加了编译器认为这是一个函数声明
	//Person p2();

	//2.2 显式法
	Person p2 = Person(10);
	Person p3 = Person(p2);
	//Person(10)单独写就是匿名对象  当前行结束之后,马上析构

	//2.3 隐式转换法
	Person p4 = 10; // Person p4 = Person(10);
	Person p5 = p4; // Person p5 = Person(p4);

	//注意2:不能利用 拷贝构造函数 初始化匿名对象 编译器认为是对象声明
	//Person p5(p4);
}

int main() {

	test01();
	//test02();

	system("pause");

	return 0;
}
4.2.3 拷贝构造函数
拷贝构造函数语法: 类名(const 类名& 对象名){}
C++ 中拷贝构造函数调用时机通常有三种情况
- 使用一个已经创建完毕的对象来初始化一个新对象
- 值传递的方式给函数参数传值,实参是个对象
- 以值方式返回局部对象(不同编译器不一样 g++ 会进行优化)
一些注意事项:
访问权限必须是 public。
函数名必须与类名相同。
没有返回值,不写 void。
如果类中定义了拷贝构造函数,编译器将不提供默认的拷贝构造函数。
拷贝构造函数可以重载,可以有默认参数。
类名(......,const 类名& 对象名,......){......}如果类中重载了拷贝构造函数却没有定义默认的拷贝构造函数,编译器也会提供默认的拷贝构造函数。
示例:
class Person {
public:
	Person() {
		cout << "无参构造函数!" << endl;
		mAge = 0;
	}
	Person(int age) {
		cout << "有参构造函数!" << endl;
		mAge = age;
	}
	Person(const Person& p) {
		cout << "拷贝构造函数!" << endl;
		mAge = p.mAge;
	}
	//析构函数在释放内存之前调用
	~Person() {
		cout << "析构函数!" << endl;
	}
public:
	int mAge;
};

//1. 使用一个已经创建完毕的对象来初始化一个新对象
void test01() {

	Person man(100); //p对象已经创建完毕
	Person newman(man); //调用拷贝构造函数
	Person newman2 = man; //拷贝构造

	//Person newman3;
	//newman3 = man; //不是调用拷贝构造函数,赋值操作
}

//2. 值传递的方式给函数参数传值
//相当于Person p1 = p;
void doWork(Person p1) {}
void test02() {
	Person p; //无参构造函数
	doWork(p);
}

//3. 以值方式返回局部对象
Person doWork2()
{
	Person p1;
	cout << (int *)&p1 << endl;
	return p1;
}

void test03()
{
	Person p = doWork2();
	cout << (int *)&p << endl;
}


int main() {

	//test01();
	//test02();
	test03();
	return 0;
}
⚠️ 经典面试题:为什么参数必须是引用(const MyClass&),而不能是值传递(const MyClass other)?
答案:为了防止无限递归。
如果参数是值传递,当你调用拷贝构造函数时,系统需要把实参 “值传递” 给形参。而 “值传递” 本身又要调用拷贝构造函数来复制数据。这样就会导致:调用拷贝构造函数 →→ 触发传值 →→ 再次调用拷贝构造函数 →→ 再次触发传值…… 最终导致栈溢出崩溃。
4.2.4 构造函数调用规则
默认情况下,c++ 编译器至少给一个类添加 3 个函数
1.默认构造函数 (无参,函数体为空)
2.默认析构函数 (无参,函数体为空)
3.默认拷贝构造函数,对属性进行值拷贝
构造函数调用规则如下:
如果用户定义有参构造函数,c++ 不在提供默认无参构造,但是会提供默认拷贝构造
如果用户定义拷贝构造函数,c++ 不会再提供其他构造函数
如果用户重载了拷贝构造函数,没有定义默认的拷贝构造函数,系统会提供默认的拷贝构造函数。
示例:
class Person {
public:
	//无参(默认)构造函数
	Person() {
		cout << "无参构造函数!" << endl;
	}
	//有参构造函数
	Person(int a) {
		age = a;
		cout << "有参构造函数!" << endl;
	}
	//拷贝构造函数
	Person(const Person& p) {
		age = p.age;
		cout << "拷贝构造函数!" << endl;
	}
	//析构函数
	~Person() {
		cout << "析构函数!" << endl;
	}
public:
	int age;
};

void test01()
{
	Person p1(18);
	//如果不写拷贝构造,编译器会自动添加拷贝构造,并且做浅拷贝操作
	Person p2(p1);

	cout << "p2的年龄为: " << p2.age << endl;
}

void test02()
{
	//如果用户提供有参构造,编译器不会提供默认构造,会提供拷贝构造
	Person p1; //此时如果用户自己没有提供默认构造,会出错
	Person p2(10); //用户提供的有参
	Person p3(p2); //此时如果用户没有提供拷贝构造,编译器会提供

	//如果用户提供拷贝构造,编译器不会提供其他构造函数
	Person p4; //此时如果用户自己没有提供默认构造,会出错
	Person p5(10); //此时如果用户自己没有提供有参,会出错
	Person p6(p5); //用户自己提供拷贝构造
}

int main() {

	test01();

	system("pause");

	return 0;
}
4.2.5 深拷贝与浅拷贝
深浅拷贝是面试经典问题,也是常见的一个坑
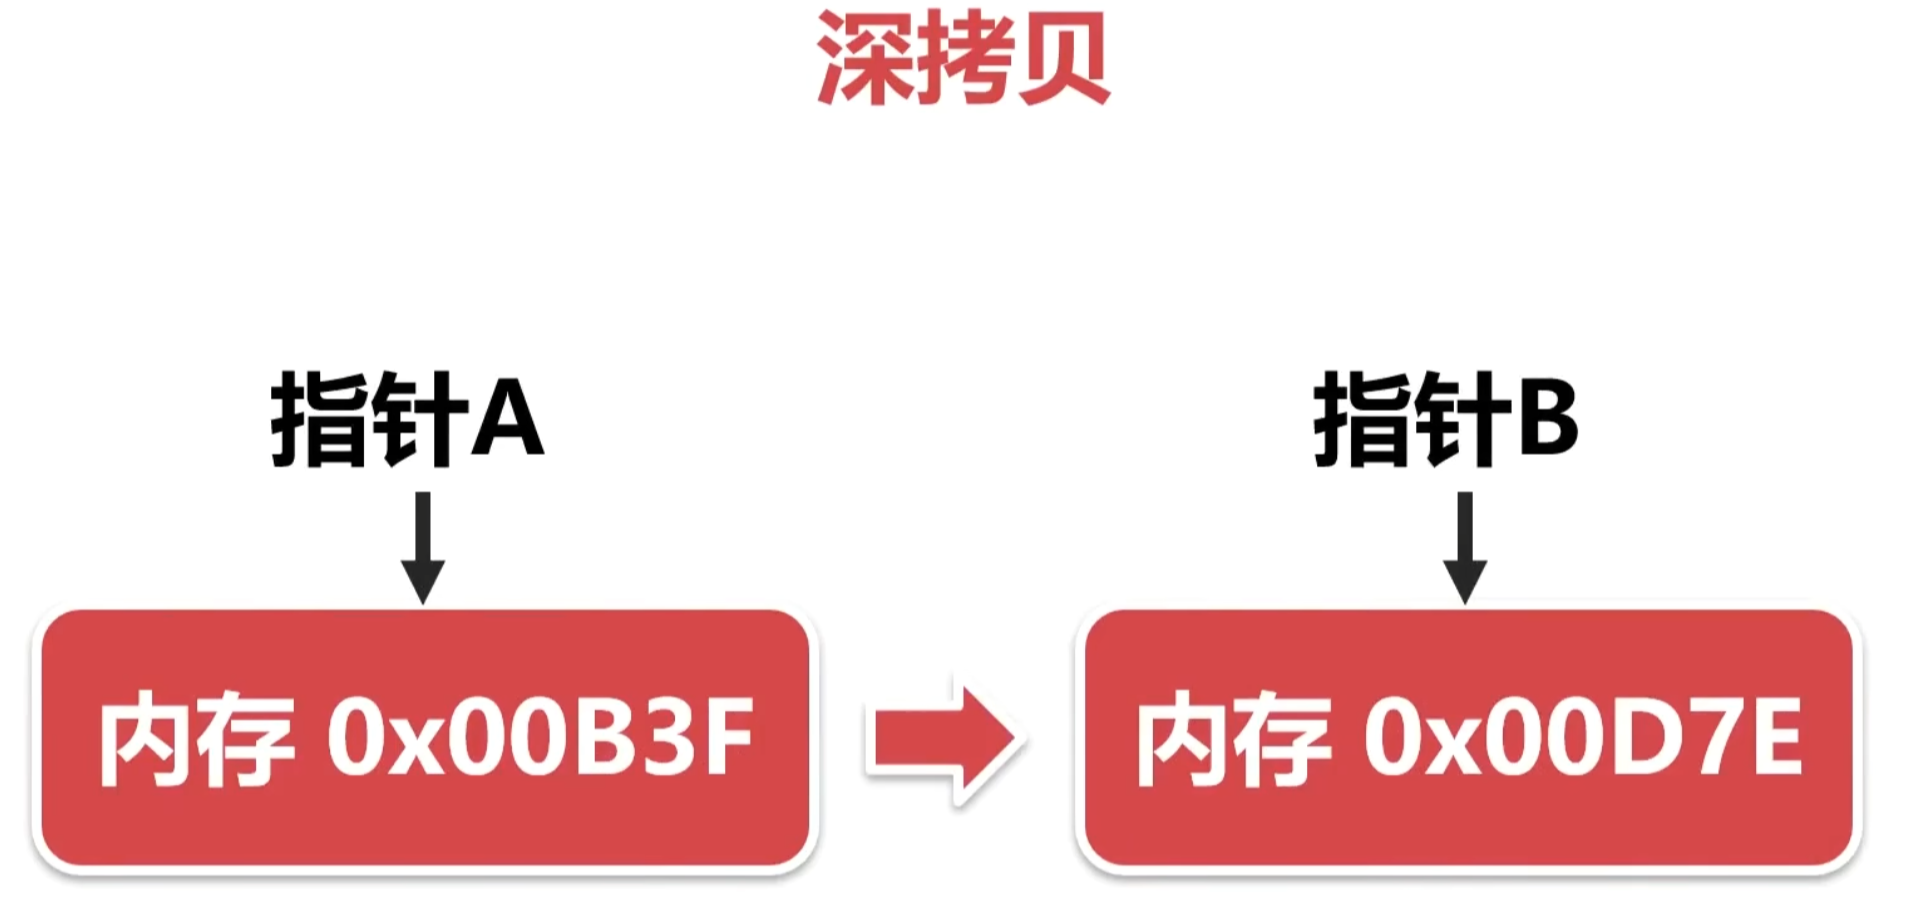
一个类中有动态分配内存的指针,如果用该类实例化了两个对象,用对象 A 初始化对象 B,那么这两个对象的指针就会指向同一块内存区域,当对象 A 销毁后,B 的指针就变成了野指针。为了避免这个问题,我们需要在类中自定义拷贝构造函数。
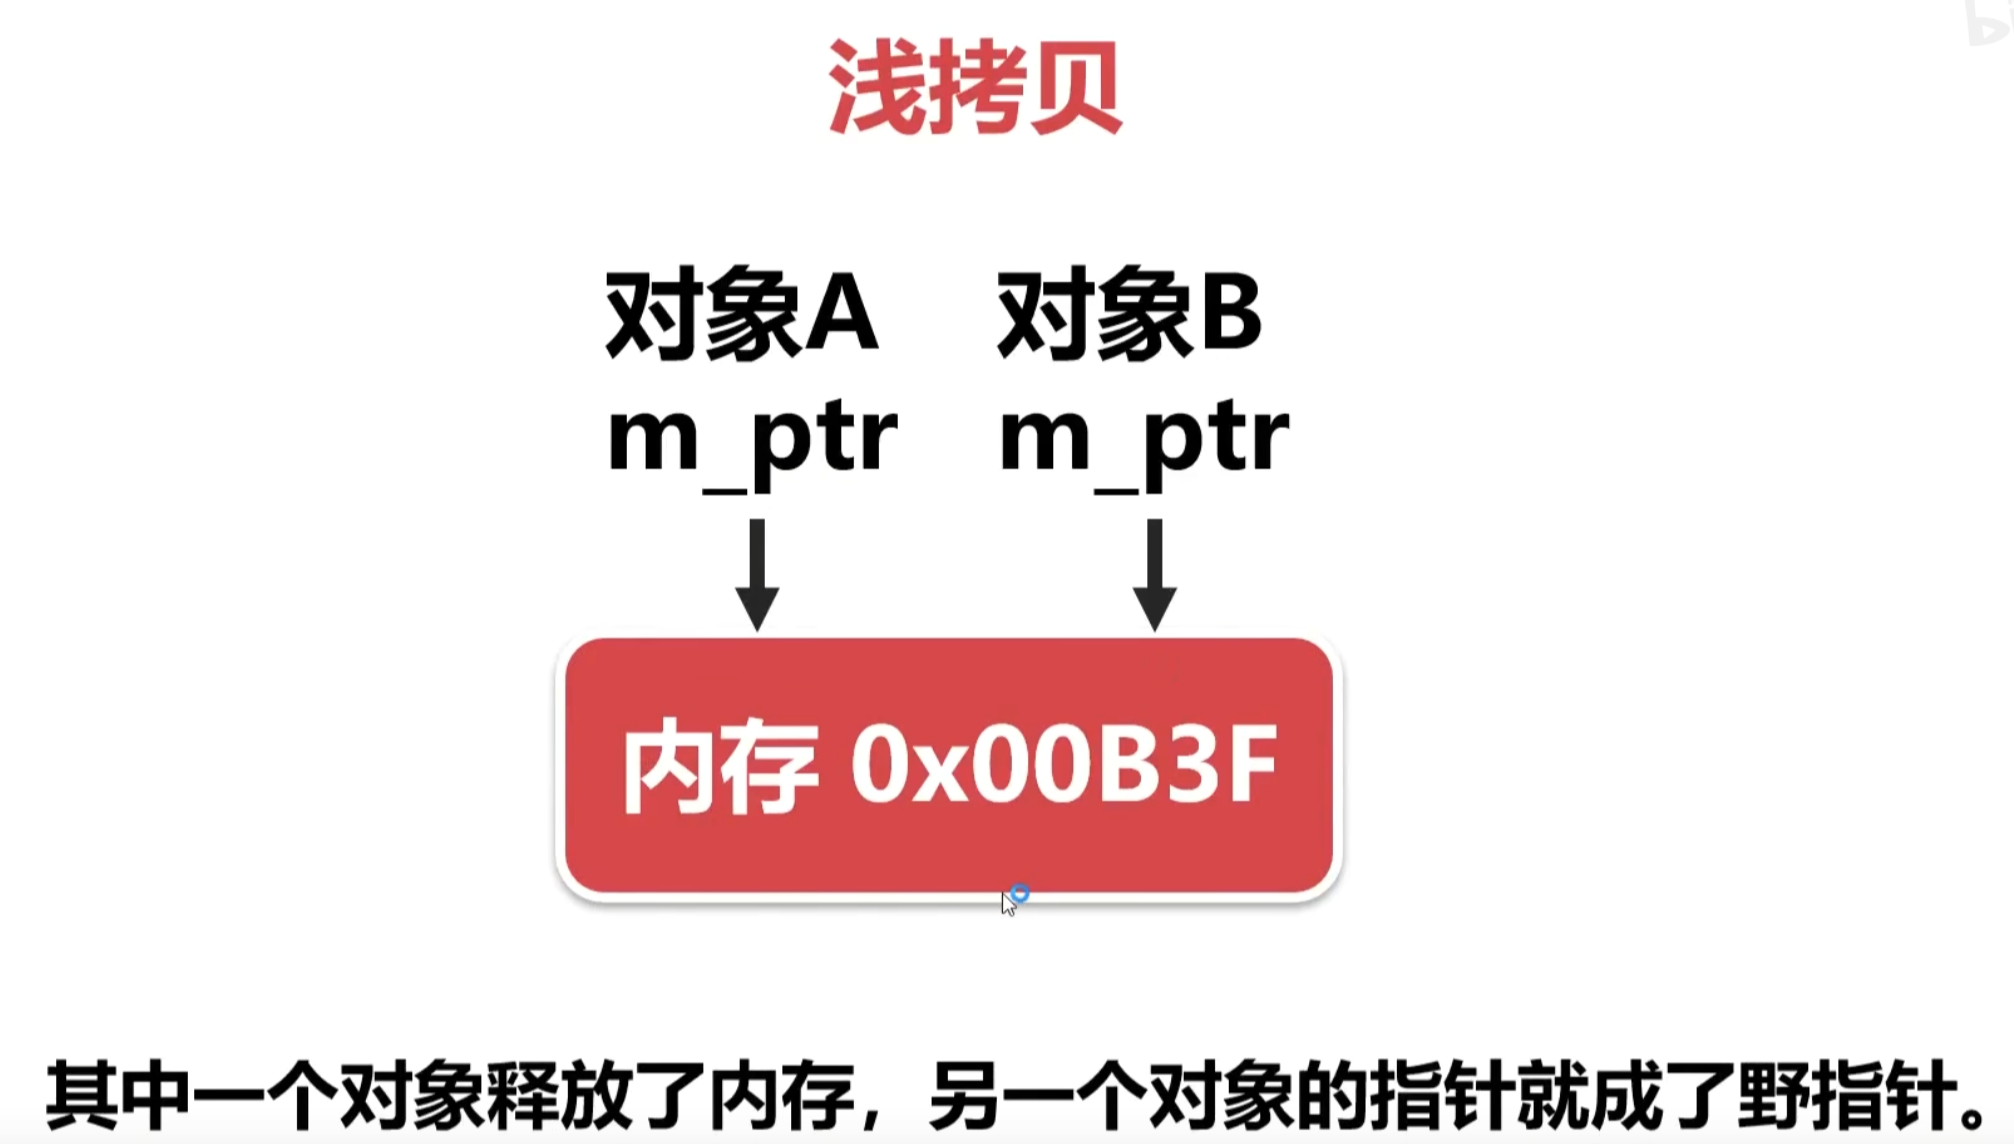
浅拷贝:简单的赋值拷贝操作
深拷贝:在堆区重新申请空间,进行拷贝操作
对象之间的赋值很容易引起浅拷贝。
示例:
class Person {
public:
	//无参(默认)构造函数
	Person() {
		cout << "无参构造函数!" << endl;
	}
	//有参构造函数
	Person(int age ,int height) {

		cout << "有参构造函数!" << endl;

		m_age = age;
		m_height = new int(height);

	}
	//拷贝构造函数
	Person(const Person& p) {
		cout << "拷贝构造函数!" << endl;
		//如果不利用深拷贝在堆区创建新内存,会导致浅拷贝带来的重复释放堆区问题
		m_age = p.m_age;
        //浅拷贝
        m_height = p.m_height
        //深拷贝
		m_height = new int(*p.m_height);

	}

	//析构函数
	~Person() {
		cout << "析构函数!" << endl;
		if (m_height != NULL)
		{
			delete m_height;
		}
	}
public:
	int m_age;
	int* m_height;
};

void test01()
{
	Person p1(18, 180);

	Person p2(p1);

	cout << "p1的年龄: " << p1.m_age << " 身高: " << *p1.m_height << endl;

	cout << "p2的年龄: " << p2.m_age << " 身高: " << *p2.m_height << endl;
}

int main() {

	test01();

	system("pause");

	return 0;
}
总结:如果属性有在堆区开辟的,一定要自己提供拷贝构造函数,编译器自己提供的拷贝构造函数是浅拷贝。
用 new 申请的内存 就在堆区。
int* ptr;
ptr=new int(3);
4.2.6 初始化列表
作用:
C++ 提供了初始化列表语法,用来初始化属性
语法: 构造函数():属性1(值1),属性2(值2)... {}
示例:
class Person {
public:

	////传统方式初始化
	//Person(int a, int b, int c) {
	//	m_A = a;
	//	m_B = b;
	//	m_C = c;
	//}

	//初始化列表方式初始化
	Person(int a, int b, int c) :m_A(a), m_B(b), m_C(c) {}
	void PrintPerson() {
		cout << "mA:" << m_A << endl;
		cout << "mB:" << m_B << endl;
		cout << "mC:" << m_C << endl;
	}
private:
	int m_A;
	int m_B;
	int m_C;
};

int main() {

	Person p(1, 2, 3);
	p.PrintPerson();


	system("pause");

	return 0;
}
函数传参相当于声明局部变量
初始化列表和赋值有本质区别,如果成员是类,使用初始化列表调用的是成员类的拷贝构造函数,赋值是先创建成员类的对象,调用成员类的普通构造函数,然后再赋值。
补充:
构造函数对自定义数据类型加引用是为了防止以值传递调用拷贝构造函数造成额外的开销。而内置类型不会有构造函数,对于内置类型以值传递往往更高效。
常对象只能调用用 const 修饰的成员函数
如果把类的成员声明成静态,就可以把它和类的对象独立开来。(静态成员不属于对象)。
delete 指针:不是把指针删除,而是释放指针指向的那块内存。指针里面存放的内存地址没有变,此时指针就变成了野指针。所以 delete 之后要加一句代码:将指针置空。p = nullptr。
C++ 规定 delete 一个空指针是安全的。
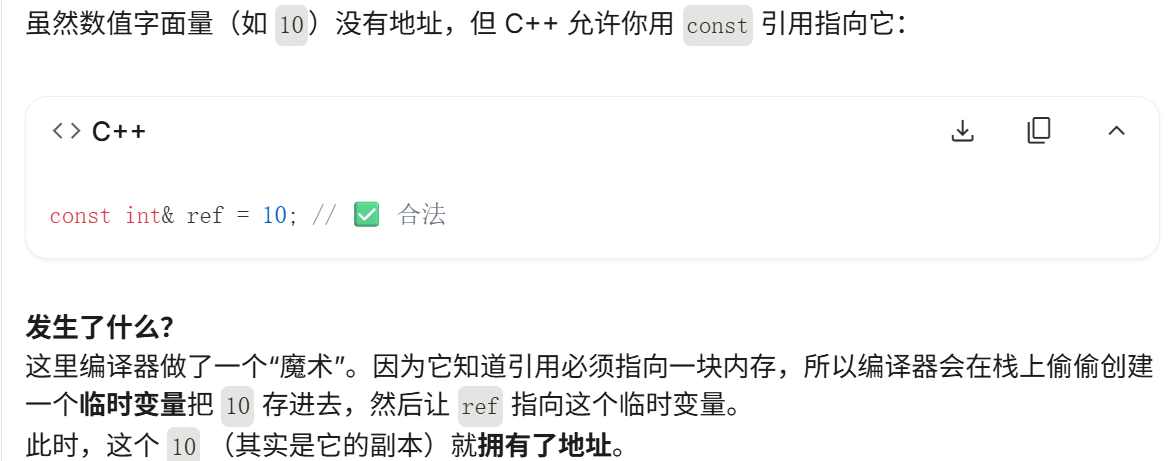
字面量没有地址。(字符串字面量是有地址的)
初始化列表很重要 C++11 的特性
4.2.7 类对象作为类成员
C++ 类中的成员可以是另一个类的对象,我们称该成员为 对象成员
例如:
class A {}
class B
{
    A a;
}
B 类中有对象 A 作为成员,A 为对象成员
那么当创建 B 对象时,A 与 B 的构造和析构的顺序是谁先谁后?
示例:
class Phone
{
public:
	Phone(string name)
	{
		m_PhoneName = name;
		cout << "Phone构造" << endl;
	}

	~Phone()
	{
		cout << "Phone析构" << endl;
	}

	string m_PhoneName;

};


class Person
{
public:

	//初始化列表可以告诉编译器调用哪一个构造函数
	Person(string name, string pName) :m_Name(name), m_Phone(pName)
	{
		cout << "Person构造" << endl;
	}

	~Person()
	{
		cout << "Person析构" << endl;
	}

	void playGame()
	{
		cout << m_Name << " 使用" << m_Phone.m_PhoneName << " 牌手机! " << endl;
	}

	string m_Name;
	Phone m_Phone;

};
void test01()
{
	//当类中成员是其他类对象时,我们称该成员为 对象成员
	//构造的顺序是 :先调用对象成员的构造,再调用本类构造
	//析构顺序与构造相反
	Person p("张三" , "苹果X");
	p.playGame();

}


int main() {

	test01();

	system("pause");

	return 0;
}
4.2.8 静态成员
静态成员就是在成员变量和成员函数前加上关键字 static,称为静态成员
静态成员分为:
- 静态成员变量
- 所有对象共享同一份数据
- 在编译阶段分配内存
- 类内声明,类外初始化
- 静态成员函数
- 所有对象共享同一个函数
- 静态成员函数只能访问静态成员变量
示例 1 : 静态成员变量
class Person
{

public:

	static int m_A; //静态成员变量

	//静态成员变量特点:
	//1 在编译阶段分配内存
	//2 类内声明,类外初始化
	//3 所有对象共享同一份数据

private:
	static int m_B; //静态成员变量也是有访问权限的
};
int Person::m_A = 10;
int Person::m_B = 10;

void test01()
{
	//静态成员变量两种访问方式

	//1、通过对象
	Person p1;
	p1.m_A = 100;
	cout << "p1.m_A = " << p1.m_A << endl;

	Person p2;
	p2.m_A = 200;
	cout << "p1.m_A = " << p1.m_A << endl; //共享同一份数据
	cout << "p2.m_A = " << p2.m_A << endl;

	//2、通过类名
	cout << "m_A = " << Person::m_A << endl;


	//cout << "m_B = " << Person::m_B << endl; //私有权限访问不到
}

int main() {

	test01();

	system("pause");

	return 0;
}
示例 2: 静态成员函数
class Person
{

public:

	//静态成员函数特点:
	//1 程序共享一个函数
	//2 静态成员函数只能访问静态成员变量

	static void func()
	{
		cout << "func调用" << endl;
		m_A = 100;
		//m_B = 100; //错误,不可以访问非静态成员变量
	}

	static int m_A; //静态成员变量
	int m_B; //
private:

	//静态成员函数也是有访问权限的
	static void func2()
	{
		cout << "func2调用" << endl;
	}
};
int Person::m_A = 10;


void test01()
{
	//静态成员变量两种访问方式

	//1、通过对象
	Person p1;
	p1.func();

	//2、通过类名
	Person::func();


	//Person::func2(); //私有权限访问不到
}

int main() {

	test01();

	system("pause");

	return 0;
}
4.3 C++ 对象模型和 this 指针
4.3.1 成员变量和成员函数分开存储
在 C++ 中,类内的成员变量和成员函数分开存储
只有非静态成员变量才属于类的对象上
class Person {
public:
	Person() {
		mA = 0;
	}
	//非静态成员变量占对象空间
	int mA;
	//静态成员变量不占对象空间
	static int mB;
	//函数也不占对象空间,所有函数共享一个函数实例
	void func() {
		cout << "mA:" << this->mA << endl;
	}
	//静态成员函数也不占对象空间
	static void sfunc() {
	}
};

int main() {

	cout << sizeof(Person) << endl;

	system("pause");

	return 0;
}
4.3.2 this 指针概念
通过 4.3.1 我们知道在 C++ 中成员变量和成员函数是分开存储的
每一个非静态成员函数只会诞生一份函数实例,也就是说多个同类型的对象会共用一块代码
那么问题是:这一块代码是如何区分那个对象调用自己的呢?
c++ 通过提供特殊的对象指针,this 指针,解决上述问题。this 指针指向被调用的成员函数所属的对象
this 指针是隐含每一个非静态成员函数内的一种指针
this 指针不需要定义,直接使用即可
谁调用成员函数,this 指针就指向谁。
this 指针的用途:
- 当形参和成员变量同名时,可用 this 指针来区分
- 在类的非静态成员函数中返回对象本身,可使用 return *this
class Person
{
public:

	Person(int age)
	{
		//1、当形参和成员变量同名时,可用this指针来区分
		this->age = age;
	}

	Person& PersonAddPerson(Person p)
	{
		this->age += p.age;
		//返回对象本身
		return *this;
	}

	int age;
};

void test01()
{
	Person p1(10);
	cout << "p1.age = " << p1.age << endl;

	Person p2(10);
	p2.PersonAddPerson(p1).PersonAddPerson(p1).PersonAddPerson(p1);
	cout << "p2.age = " << p2.age << endl;
}

int main() {

	test01();

	system("pause");

	return 0;
}
4.3.3 空指针访问成员函数
C++ 中空指针也是可以调用成员函数的,但是也要注意有没有用到 this 指针
如果用到 this 指针,需要加以判断保证代码的健壮性
示例:
//空指针访问成员函数
class Person {
public:

	void ShowClassName() {
		cout << "我是Person类!" << endl;
	}

	void ShowPerson() {
		if (this == NULL) {
			return;
		}
		cout << mAge << endl;
	}

public:
	int mAge;
};

void test01()
{
	Person * p = NULL;
	p->ShowClassName(); //空指针,可以调用成员函数
	p->ShowPerson();  //但是如果成员函数中用到了this指针,就不可以了
}

int main() {

	test01();

	system("pause");

	return 0;
}
4.3.4 const 修饰成员函数
常函数:
- 成员函数后加 const 后我们称为这个函数为常函数
- 常函数内不可以修改成员属性
- 成员属性声明时加关键字 mutable 后,在常函数中依然可以修改
常对象:
- 声明对象前加 const 称该对象为常对象
- 常对象只能调用常函数
示例:
class Person {
public:
	Person() {
		m_A = 0;
		m_B = 0;
	}

	//this指针的本质是一个指针常量,指针的指向不可修改
	//如果想让指针指向的值也不可以修改,需要声明常函数
	void ShowPerson() const {
		//const Type* const pointer;
		//this = NULL; //不能修改指针的指向 Person* const this;
		//this->mA = 100; //但是this指针指向的对象的数据是可以修改的

		//const修饰成员函数,表示指针指向的内存空间的数据不能修改,除了mutable修饰的变量
		this->m_B = 100;
	}

	void MyFunc() const {
		//mA = 10000;
	}

public:
	int m_A;
	mutable int m_B; //可修改 可变的
};


//const修饰对象  常对象
void test01() {

	const Person person; //常量对象
	cout << person.m_A << endl;
	//person.mA = 100; //常对象不能修改成员变量的值,但是可以访问
	person.m_B = 100; //但是常对象可以修改mutable修饰成员变量

	//常对象访问成员函数
	person.MyFunc(); //常对象不能调用const的函数

}

int main() {

	test01();

	system("pause");

	return 0;
}
简单对象模型
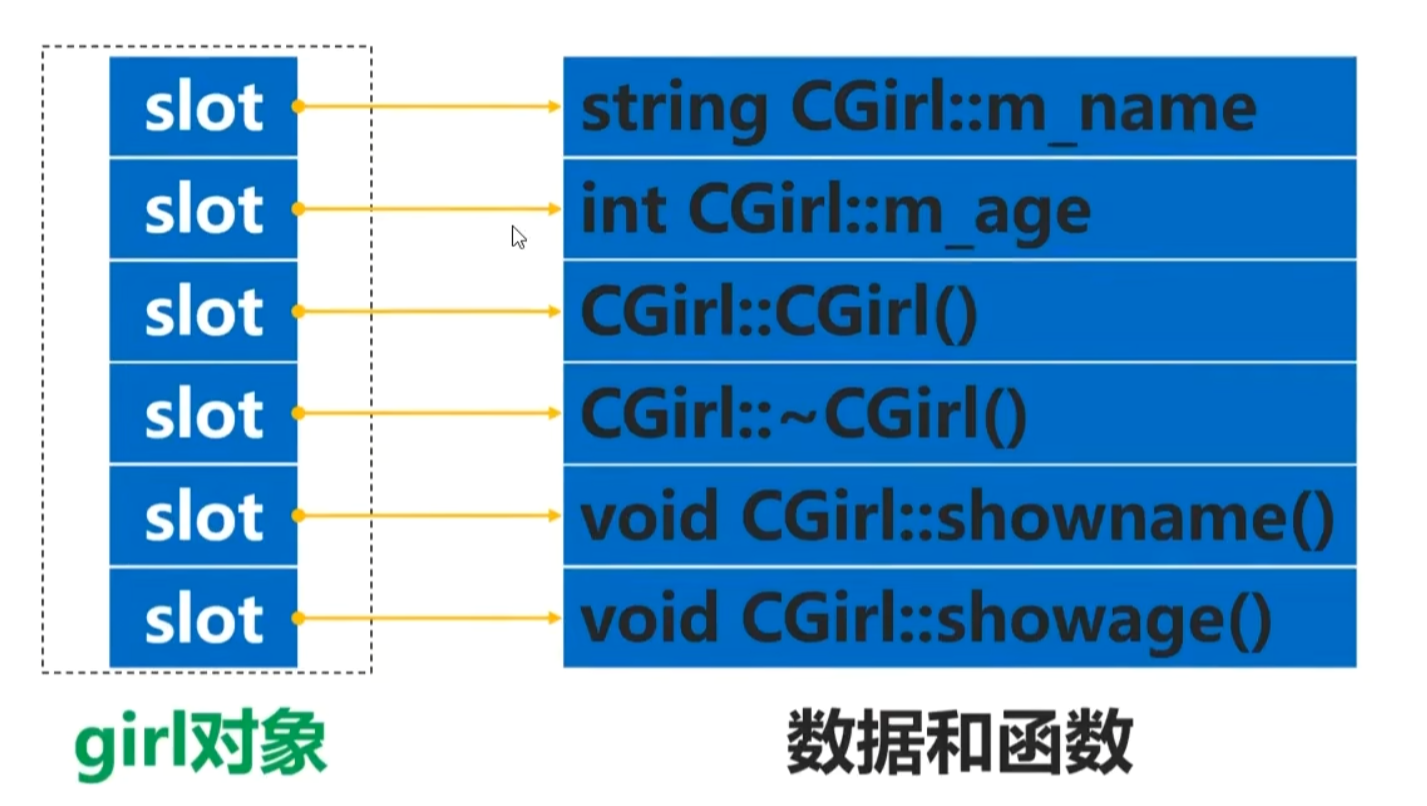
对象指针表将成员函数和成员变量关联起来了。
类的成员函数是分开存储的,存放在内存四区的代码段,不管创建了多少对象,在内存中只有一个副本,占用的内存也不会计算到对象大小中。
4.4 友元
生活中你的家有客厅 (Public),有你的卧室 (Private)
客厅所有来的客人都可以进去,但是你的卧室是私有的,也就是说只有你能进去
但是呢,你也可以允许你的好闺蜜好基友进去。
在程序里,有些私有属性 也想让类外特殊的一些函数或者类进行访问,就需要用到友元的技术
友元的目的就是让一个函数或者类 访问另一个类中私有成员
友元的关键字为 friend
友元的三种实现
- 全局函数做友元
- 类做友元
- 成员函数做友元
4.4.1 全局函数做友元
class Building
{
	//告诉编译器 goodGay全局函数 是 Building类的好朋友,可以访问类中的私有内容
	friend void goodGay(Building * building);

public:

	Building()
	{
		this->m_SittingRoom = "客厅";
		this->m_BedRoom = "卧室";
	}


public:
	string m_SittingRoom; //客厅

private:
	string m_BedRoom; //卧室
};


void goodGay(Building * building)
{
	cout << "好基友正在访问: " << building->m_SittingRoom << endl;
	cout << "好基友正在访问: " << building->m_BedRoom << endl;
}


void test01()
{
	Building b;
	goodGay(&b);
}

int main(){

	test01();

	system("pause");
	return 0;
}
4.4.2 类做友元
class Building;
class goodGay
{
public:

	goodGay();
	void visit();

private:
	Building *building;
};


class Building
{
	//告诉编译器 goodGay类是Building类的好朋友,可以访问到Building类中私有内容
	friend class goodGay;

public:
	Building();

public:
	string m_SittingRoom; //客厅
private:
	string m_BedRoom;//卧室
};

Building::Building()
{
	this->m_SittingRoom = "客厅";
	this->m_BedRoom = "卧室";
}

goodGay::goodGay()
{
	building = new Building;
}

void goodGay::visit()
{
	cout << "好基友正在访问" << building->m_SittingRoom << endl;
	cout << "好基友正在访问" << building->m_BedRoom << endl;
}

void test01()
{
	goodGay gg;
	gg.visit();

}

int main(){

	test01();

	system("pause");
	return 0;
}
4.4.3 成员函数做友元
class Building;
class goodGay
{
public:

	goodGay();
	void visit(); //只让visit函数作为Building的好朋友,可以访问Building中私有内容
	void visit2();

private:
	Building *building;
};


class Building
{
	//告诉编译器  goodGay类中的visit成员函数 是Building好朋友,可以访问私有内容
	friend void goodGay::visit();

public:
	Building();

public:
	string m_SittingRoom; //客厅
private:
	string m_BedRoom;//卧室
};

Building::Building()
{
	this->m_SittingRoom = "客厅";
	this->m_BedRoom = "卧室";
}

goodGay::goodGay()
{
	building = new Building;
}

void goodGay::visit()
{
	cout << "好基友正在访问" << building->m_SittingRoom << endl;
	cout << "好基友正在访问" << building->m_BedRoom << endl;
}

void goodGay::visit2()
{
	cout << "好基友正在访问" << building->m_SittingRoom << endl;
	//cout << "好基友正在访问" << building->m_BedRoom << endl;
}

void test01()
{
	goodGay  gg;
	gg.visit();

}

int main(){

	test01();

	system("pause");
	return 0;
}
4.5 运算符重载
运算符重载概念:对已有的运算符重新进行定义,赋予其另一种功能,以适应不同的数据类型
4.5.1 加号运算符重载
作用:实现两个自定义数据类型相加的运算
class Person {
public:
	Person() {};
	Person(int a, int b)
	{
		this->m_A = a;
		this->m_B = b;
	}
	//成员函数实现 + 号运算符重载
	Person operator+(const Person& p) {
		Person temp;
		temp.m_A = this->m_A + p.m_A;
		temp.m_B = this->m_B + p.m_B;
		return temp;
	}


public:
	int m_A;
	int m_B;
};

//全局函数实现 + 号运算符重载
//Person operator+(const Person& p1, const Person& p2) {
//	Person temp(0, 0);
//	temp.m_A = p1.m_A + p2.m_A;
//	temp.m_B = p1.m_B + p2.m_B;
//	return temp;
//}

//运算符重载 可以发生函数重载
Person operator+(const Person& p2, int val)
{
	Person temp;
	temp.m_A = p2.m_A + val;
	temp.m_B = p2.m_B + val;
	return temp;
}

void test() {

	Person p1(10, 10);
	Person p2(20, 20);

	//成员函数方式
	Person p3 = p2 + p1;  //相当于 p2.operaor+(p1)
	cout << "mA:" << p3.m_A << " mB:" << p3.m_B << endl;


	Person p4 = p3 + 10; //相当于 operator+(p3,10)
	cout << "mA:" << p4.m_A << " mB:" << p4.m_B << endl;

}

int main() {

	test();

	system("pause");

	return 0;
}
总结 1:对于内置的数据类型的表达式的的运算符是不可能改变的
总结 2:不要滥用运算符重载
4.5.2 左移运算符重载
作用:可以输出自定义数据类型
class Person {
	friend ostream& operator<<(ostream& out, Person& p);

public:

	Person(int a, int b)
	{
		this->m_A = a;
		this->m_B = b;
	}

	//成员函数 实现不了  p << cout 不是我们想要的效果
	//void operator<<(Person& p){
	//}

private:
	int m_A;
	int m_B;
};

//全局函数实现左移重载
//ostream对象只能有一个
ostream& operator<<(ostream& out, Person& p) {
	out << "a:" << p.m_A << " b:" << p.m_B;
	return out;
}

void test() {

	Person p1(10, 20);

	cout << p1 << "hello world" << endl; //链式编程
}

int main() {

	test();

	system("pause");

	return 0;
}
总结:重载左移运算符配合友元可以实现输出自定义数据类型
4.5.3 递增运算符重载
作用: 通过重载递增运算符,实现自己的整型数据
class MyInteger {

	friend ostream& operator<<(ostream& out, MyInteger myint);

public:
	MyInteger() {
		m_Num = 0;
	}
	//前置++
	MyInteger& operator++() {
		//先++
		m_Num++;
		//再返回
		return *this;
	}

	//后置++
	MyInteger operator++(int) {
		//先返回
		MyInteger temp = *this; //记录当前本身的值,然后让本身的值加1,但是返回的是以前的值,达到先返回后++;
		m_Num++;
		return temp;
	}

private:
	int m_Num;
};


ostream& operator<<(ostream& out, MyInteger myint) {
	out << myint.m_Num;
	return out;
}


//前置++ 先++ 再返回
void test01() {
	MyInteger myInt;
	cout << ++myInt << endl;
	cout << myInt << endl;
}

//后置++ 先返回 再++
void test02() {

	MyInteger myInt;
	cout << myInt++ << endl;
	cout << myInt << endl;
}

int main() {

	test01();
	//test02();

	system("pause");

	return 0;
}
总结: 前置递增返回引用,后置递增返回值
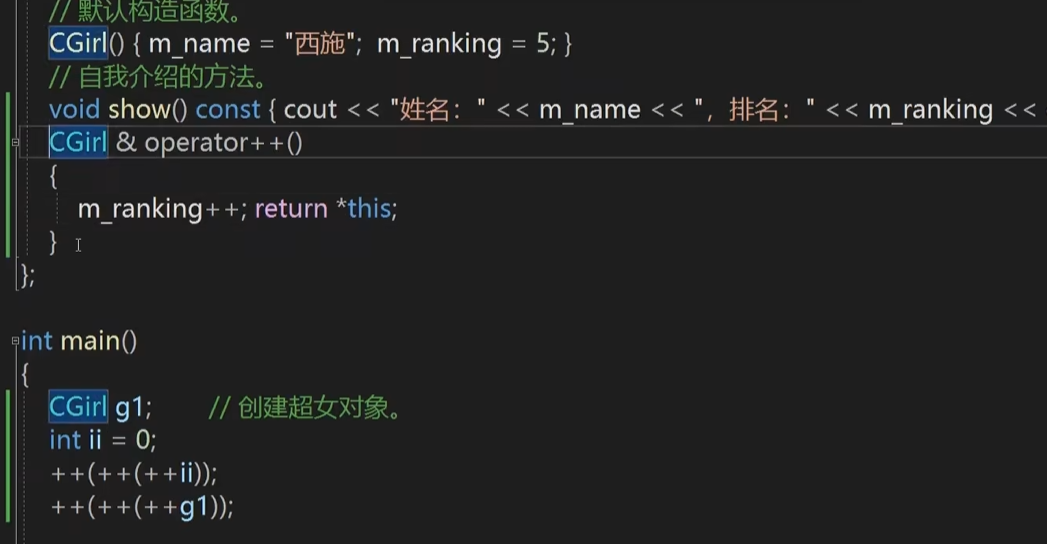
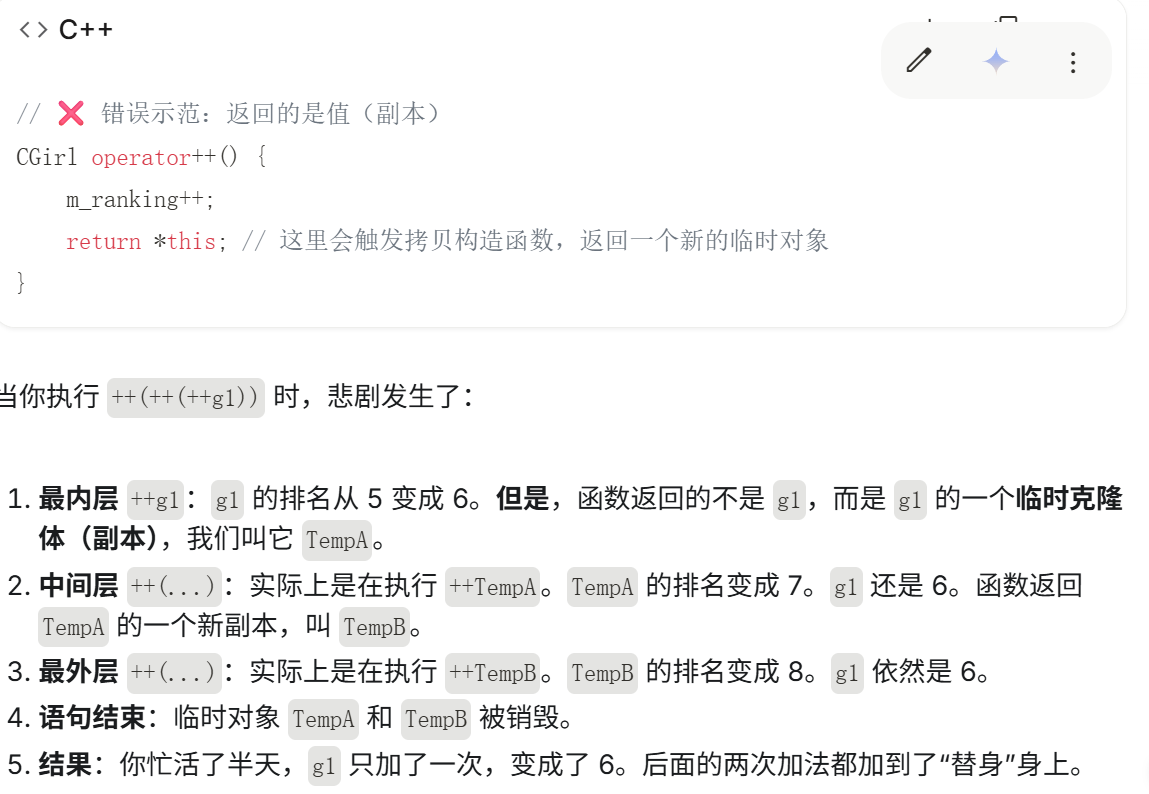
重载 + 前置运算符为什么返回的是 CGirl 引用,能不能直接返回 CGirl 类?
4.5.4 赋值运算符重载
c++ 编译器至少给一个类添加 4 个函数
- 默认构造函数 (无参,函数体为空)
- 默认析构函数 (无参,函数体为空)
- 默认拷贝构造函数,对属性进行值拷贝
- 赋值运算符 operator=, 对属性进行值拷贝
如果类中有属性指向堆区,做赋值操作时也会出现深浅拷贝问题
示例:
class Person
{
public:

	Person(int age)
	{
		//将年龄数据开辟到堆区
		m_Age = new int(age);
	}

	//重载赋值运算符
	Person& operator=(Person &p)
	{
		if (m_Age != NULL)
		{
			delete m_Age;
			m_Age = NULL;
		}
		//编译器提供的代码是浅拷贝
		//m_Age = p.m_Age;

		//提供深拷贝 解决浅拷贝的问题
		m_Age = new int(*p.m_Age);

		//返回自身
		return *this;
	}


	~Person()
	{
		if (m_Age != NULL)
		{
			delete m_Age;
			m_Age = NULL;
		}
	}

	//年龄的指针
	int *m_Age;

};


void test01()
{
	Person p1(18);

	Person p2(20);

	Person p3(30);

	p3 = p2 = p1; //赋值操作

	cout << "p1的年龄为:" << *p1.m_Age << endl;

	cout << "p2的年龄为:" << *p2.m_Age << endl;

	cout << "p3的年龄为:" << *p3.m_Age << endl;
}

int main() {

	test01();

	//int a = 10;
	//int b = 20;
	//int c = 30;

	//c = b = a;
	//cout << "a = " << a << endl;
	//cout << "b = " << b << endl;
	//cout << "c = " << c << endl;

	system("pause");

	return 0;
}
4.5.5 关系运算符重载
作用: 重载关系运算符,可以让两个自定义类型对象进行对比操作
示例:
class Person
{
public:
	Person(string name, int age)
	{
		this->m_Name = name;
		this->m_Age = age;
	};

	bool operator==(Person & p)
	{
		if (this->m_Name == p.m_Name && this->m_Age == p.m_Age)
		{
			return true;
		}
		else
		{
			return false;
		}
	}

	bool operator!=(Person & p)
	{
		if (this->m_Name == p.m_Name && this->m_Age == p.m_Age)
		{
			return false;
		}
		else
		{
			return true;
		}
	}

	string m_Name;
	int m_Age;
};

void test01()
{
	//int a = 0;
	//int b = 0;

	Person a("孙悟空", 18);
	Person b("孙悟空", 18);

	if (a == b)
	{
		cout << "a和b相等" << endl;
	}
	else
	{
		cout << "a和b不相等" << endl;
	}

	if (a != b)
	{
		cout << "a和b不相等" << endl;
	}
	else
	{
		cout << "a和b相等" << endl;
	}
}


int main() {

	test01();

	system("pause");

	return 0;
}
4.5.6 函数调用运算符重载
- 函数调用运算符 () 也可以重载
- 由于重载后使用的方式非常像函数的调用,因此称为仿函数
- 仿函数没有固定写法,非常灵活
示例:
class MyPrint
{
public:
	void operator()(string text)
	{
		cout << text << endl;
	}

};
void test01()
{
	//重载的()操作符 也称为仿函数
	MyPrint myFunc;
	myFunc("hello world");
}


class MyAdd
{
public:
	int operator()(int v1, int v2)
	{
		return v1 + v2;
	}
};

void test02()
{
	MyAdd add;
	int ret = add(10, 10);
	cout << "ret = " << ret << endl;

	//匿名对象调用
	cout << "MyAdd()(100,100) = " << MyAdd()(100, 100) << endl;
}

int main() {

	test01();
	test02();

	system("pause");

	return 0;
}
4.6 继承
继承是面向对象三大特性之一
有些类与类之间存在特殊的关系,例如下图中:
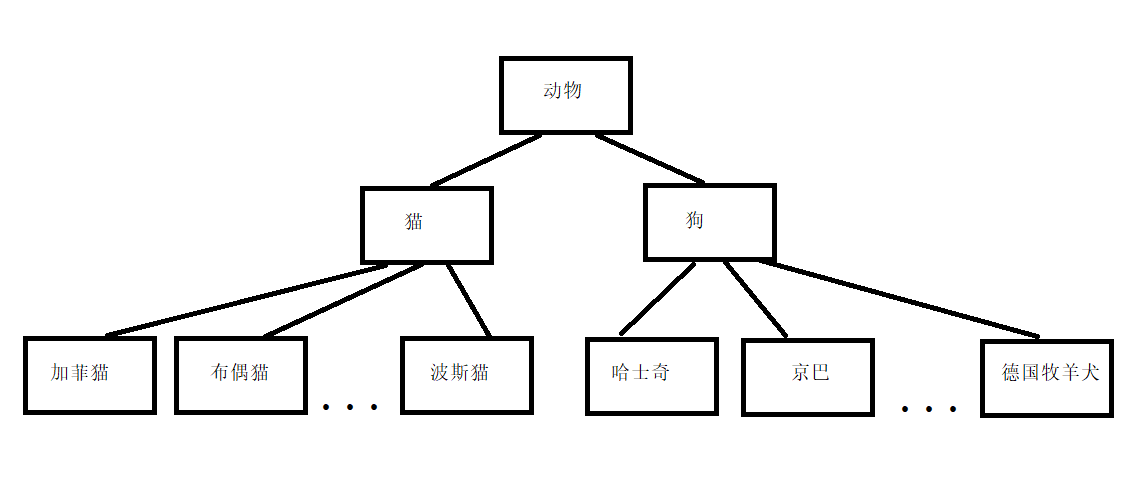
我们发现,定义这些类时,下级别的成员除了拥有上一级的共性,还有自己的特性。
这个时候我们就可以考虑利用继承的技术,减少重复代码
继承的基本语法
例如我们看到很多网站中,都有公共的头部,公共的底部,甚至公共的左侧列表,只有中心内容不同
接下来我们分别利用普通写法和继承的写法来实现网页中的内容,看一下继承存在的意义以及好处
普通实现:
//Java页面
class Java
{
public:
	void header()
	{
		cout << "首页、公开课、登录、注册...(公共头部)" << endl;
	}
	void footer()
	{
		cout << "帮助中心、交流合作、站内地图...(公共底部)" << endl;
	}
	void left()
	{
		cout << "Java,Python,C++...(公共分类列表)" << endl;
	}
	void content()
	{
		cout << "JAVA学科视频" << endl;
	}
};
//Python页面
class Python
{
public:
	void header()
	{
		cout << "首页、公开课、登录、注册...(公共头部)" << endl;
	}
	void footer()
	{
		cout << "帮助中心、交流合作、站内地图...(公共底部)" << endl;
	}
	void left()
	{
		cout << "Java,Python,C++...(公共分类列表)" << endl;
	}
	void content()
	{
		cout << "Python学科视频" << endl;
	}
};
//C++页面
class CPP
{
public:
	void header()
	{
		cout << "首页、公开课、登录、注册...(公共头部)" << endl;
	}
	void footer()
	{
		cout << "帮助中心、交流合作、站内地图...(公共底部)" << endl;
	}
	void left()
	{
		cout << "Java,Python,C++...(公共分类列表)" << endl;
	}
	void content()
	{
		cout << "C++学科视频" << endl;
	}
};

void test01()
{
	//Java页面
	cout << "Java下载视频页面如下: " << endl;
	Java ja;
	ja.header();
	ja.footer();
	ja.left();
	ja.content();
	cout << "--------------------" << endl;

	//Python页面
	cout << "Python下载视频页面如下: " << endl;
	Python py;
	py.header();
	py.footer();
	py.left();
	py.content();
	cout << "--------------------" << endl;

	//C++页面
	cout << "C++下载视频页面如下: " << endl;
	CPP cp;
	cp.header();
	cp.footer();
	cp.left();
	cp.content();

}

int main() {

	test01();

	system("pause");

	return 0;
}
继承实现:
//公共页面
class BasePage
{
public:
	void header()
	{
		cout << "首页、公开课、登录、注册...(公共头部)" << endl;
	}

	void footer()
	{
		cout << "帮助中心、交流合作、站内地图...(公共底部)" << endl;
	}
	void left()
	{
		cout << "Java,Python,C++...(公共分类列表)" << endl;
	}

};

//Java页面
class Java : public BasePage
{
public:
	void content()
	{
		cout << "JAVA学科视频" << endl;
	}
};
//Python页面
class Python : public BasePage
{
public:
	void content()
	{
		cout << "Python学科视频" << endl;
	}
};
//C++页面
class CPP : public BasePage
{
public:
	void content()
	{
		cout << "C++学科视频" << endl;
	}
};

void test01()
{
	//Java页面
	cout << "Java下载视频页面如下: " << endl;
	Java ja;
	ja.header();
	ja.footer();
	ja.left();
	ja.content();
	cout << "--------------------" << endl;

	//Python页面
	cout << "Python下载视频页面如下: " << endl;
	Python py;
	py.header();
	py.footer();
	py.left();
	py.content();
	cout << "--------------------" << endl;

	//C++页面
	cout << "C++下载视频页面如下: " << endl;
	CPP cp;
	cp.header();
	cp.footer();
	cp.left();
	cp.content();


}

int main() {

	test01();

	system("pause");

	return 0;
}
总结:
继承的好处:可以减少重复的代码
class A : public B;
A 类称为子类 或 派生类
B 类称为父类 或 基类
派生类中的成员,包含两大部分:
一类是从基类继承过来的,一类是自己增加的成员。
从基类继承过过来的表现其共性,而新增的成员体现了其个性。
继承方式
继承的语法: class 子类 : 继承方式 父类
继承方式一共有三种:
- 公共继承
- 保护继承
- 私有继承
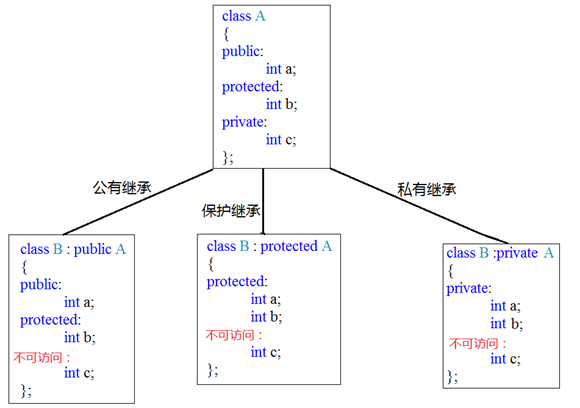
示例:
class Base1
{
public:
	int m_A;
protected:
	int m_B;
private:
	int m_C;
};

//公共继承
class Son1 :public Base1
{
public:
	void func()
	{
		m_A; //可访问 public权限
		m_B; //可访问 protected权限
		//m_C; //不可访问
	}
};

void myClass()
{
	Son1 s1;
	s1.m_A; //其他类只能访问到公共权限
}

//保护继承
class Base2
{
public:
	int m_A;
protected:
	int m_B;
private:
	int m_C;
};
class Son2:protected Base2
{
public:
	void func()
	{
		m_A; //可访问 protected权限
		m_B; //可访问 protected权限
		//m_C; //不可访问
	}
};
void myClass2()
{
	Son2 s;
	//s.m_A; //不可访问
}

//私有继承
class Base3
{
public:
	int m_A;
protected:
	int m_B;
private:
	int m_C;
};
class Son3:private Base3
{
public:
	void func()
	{
		m_A; //可访问 private权限
		m_B; //可访问 private权限
		//m_C; //不可访问
	}
};
class GrandSon3 :public Son3
{
public:
	void func()
	{
		//Son3是私有继承,所以继承Son3的属性在GrandSon3中都无法访问到
		//m_A;
		//m_B;
		//m_C;
	}
};
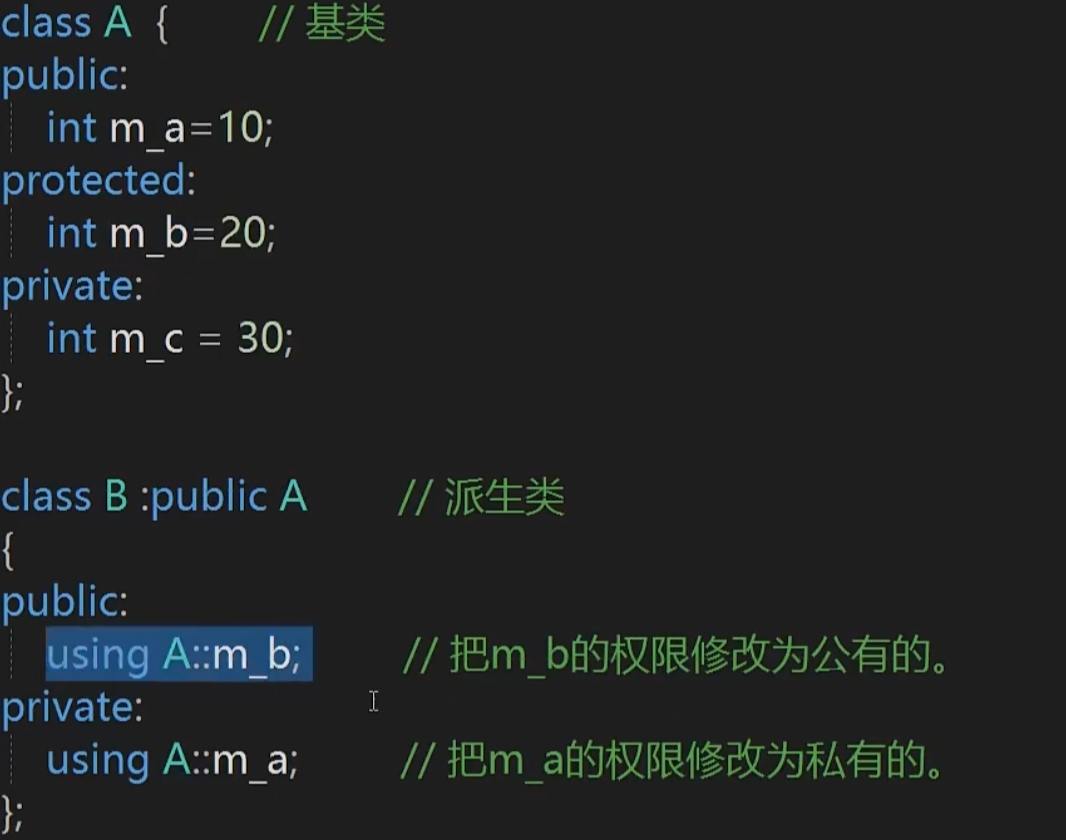
在派生类中,可以通过基类的公有成员函数间接访问基类的私有成员。
使用 using 关键字可以改变基类成员在派生类中的访问权限。
继承中的对象模型
问题: 从父类继承过来的成员,哪些属于子类对象中?
示例:
class Base
{
public:
	int m_A;
protected:
	int m_B;
private:
	int m_C; //私有成员只是被隐藏了,但是还是会继承下去
};

//公共继承
class Son :public Base
{
public:
	int m_D;
};

void test01()
{
	cout << "sizeof Son = " << sizeof(Son) << endl;
}

int main() {

	test01();

	system("pause");

	return 0;
}
利用工具查看:
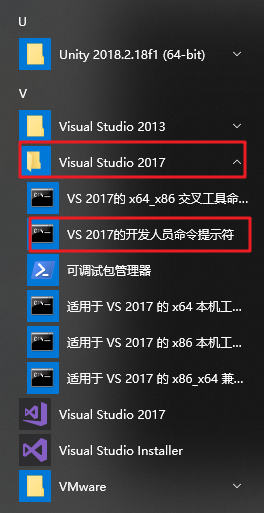
打开工具窗口后,定位到当前 CPP 文件的盘符
然后输入: cl /d1 reportSingleClassLayout 查看的类名 所属文件名
效果如下图:
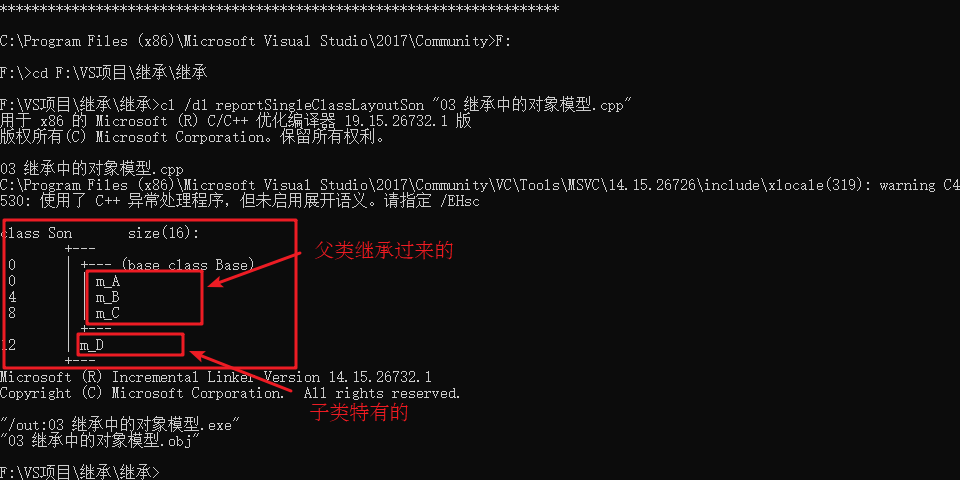
结论: 父类中私有成员也是被子类继承下去了,只是由编译器给隐藏后访问不 到
继承中构造和析构顺序
子类继承父类后,当创建子类对象,也会调用父类的构造函数
问题:父类和子类的构造和析构顺序是谁先谁后?
示例:
class Base
{
public:
	Base()
	{
		cout << "Base构造函数!" << endl;
	}
	~Base()
	{
		cout << "Base析构函数!" << endl;
	}
};

class Son : public Base
{
public:
	Son()
	{
		cout << "Son构造函数!" << endl;
	}
	~Son()
	{
		cout << "Son析构函数!" << endl;
	}

};


void test01()
{
	//继承中 先调用父类构造函数,再调用子类构造函数,析构顺序与构造相反
	Son s;
}

int main() {

	test01();

	system("pause");

	return 0;
}
总结:继承中 先调用父类构造函数,再调用子类构造函数,析构顺序与构造相反
派生类的析构函数被调用后,会自动调用基类的析构函数。
名字遮蔽与类作用域
问题:当子类与父类出现同名的成员,如何通过子类对象,访问到子类或父类中同名的数据呢?
- 访问子类同名成员 直接访问即可
- 访问父类同名成员 需要加作用域
示例:
class Base {
public:
	Base()
	{
		m_A = 100;
	}

	void func()
	{
		cout << "Base - func()调用" << endl;
	}

	void func(int a)
	{
		cout << "Base - func(int a)调用" << endl;
	}

public:
	int m_A;
};


class Son : public Base {
public:
	Son()
	{
		m_A = 200;
	}

	//当子类与父类拥有同名的成员函数,子类会隐藏父类中所有版本的同名成员函数
	//如果想访问父类中被隐藏的同名成员函数,需要加父类的作用域
	void func()
	{
		cout << "Son - func()调用" << endl;
	}
public:
	int m_A;
};

void test01()
{
	Son s;

	cout << "Son下的m_A = " << s.m_A << endl;
	cout << "Base下的m_A = " << s.Base::m_A << endl;

	s.func();
	s.Base::func();
	s.Base::func(10);

}
int main() {

	test01();

	system("pause");
	return EXIT_SUCCESS;
}
总结:
- 子类对象可以直接访问到子类中同名成员
- 子类对象加作用域可以访问到父类同名成员
- 当子类与父类拥有同名的成员函数,子类会隐藏父类中同名成员函数,加作用域可以访问到父类中同名函数
继承同名静态成员处理方式
问题:继承中同名的静态成员在子类对象上如何进行访问?
静态成员和非静态成员出现同名,处理方式一致
- 访问子类同名成员 直接访问即可
- 访问父类同名成员 需要加作用域
示例:
class Base {
public:
	static void func()
	{
		cout << "Base - static void func()" << endl;
	}
	static void func(int a)
	{
		cout << "Base - static void func(int a)" << endl;
	}

	static int m_A;
};

int Base::m_A = 100;

class Son : public Base {
public:
	static void func()
	{
		cout << "Son - static void func()" << endl;
	}
	static int m_A;
};

int Son::m_A = 200;

//同名成员属性
void test01()
{
	//通过对象访问
	cout << "通过对象访问: " << endl;
	Son s;
	cout << "Son  下 m_A = " << s.m_A << endl;
	cout << "Base 下 m_A = " << s.Base::m_A << endl;

	//通过类名访问
	cout << "通过类名访问: " << endl;
	cout << "Son  下 m_A = " << Son::m_A << endl;
	cout << "Base 下 m_A = " << Son::Base::m_A << endl;
}

//同名成员函数
void test02()
{
	//通过对象访问
	cout << "通过对象访问: " << endl;
	Son s;
	s.func();
	s.Base::func();

	cout << "通过类名访问: " << endl;
	Son::func();
	Son::Base::func();
	//出现同名,子类会隐藏掉父类中所有同名成员函数,需要加作作用域访问
	Son::Base::func(100);
}
int main() {

	//test01();
	test02();

	system("pause");

	return 0;
}
总结:同名静态成员处理方式和非静态处理方式一样,只不过有两种访问的方式(通过对象 和 通过类名)
多继承语法
C++ 允许一个类继承多个类
语法: class 子类 :继承方式 父类1 , 继承方式 父类2...
多继承可能会引发父类中有同名成员出现,需要加作用域区分
C++ 实际开发中不建议用多继承
示例:
class Base1 {
public:
	Base1()
	{
		m_A = 100;
	}
public:
	int m_A;
};

class Base2 {
public:
	Base2()
	{
		m_A = 200;  //开始是m_B 不会出问题,但是改为mA就会出现不明确
	}
public:
	int m_A;
};

//语法:class 子类:继承方式 父类1 ,继承方式 父类2
class Son : public Base2, public Base1
{
public:
	Son()
	{
		m_C = 300;
		m_D = 400;
	}
public:
	int m_C;
	int m_D;
};


//多继承容易产生成员同名的情况
//通过使用类名作用域可以区分调用哪一个基类的成员
void test01()
{
	Son s;
	cout << "sizeof Son = " << sizeof(s) << endl;
	cout << s.Base1::m_A << endl;
	cout << s.Base2::m_A << endl;
}

int main() {

	test01();

	system("pause");

	return 0;
}
总结: 多继承中如果父类中出现了同名情况,子类使用时候要加作用域
菱形继承
菱形继承概念:
两个派生类继承同一个基类
又有某个类同时继承者两个派生类
这种继承被称为菱形继承,或者钻石继承
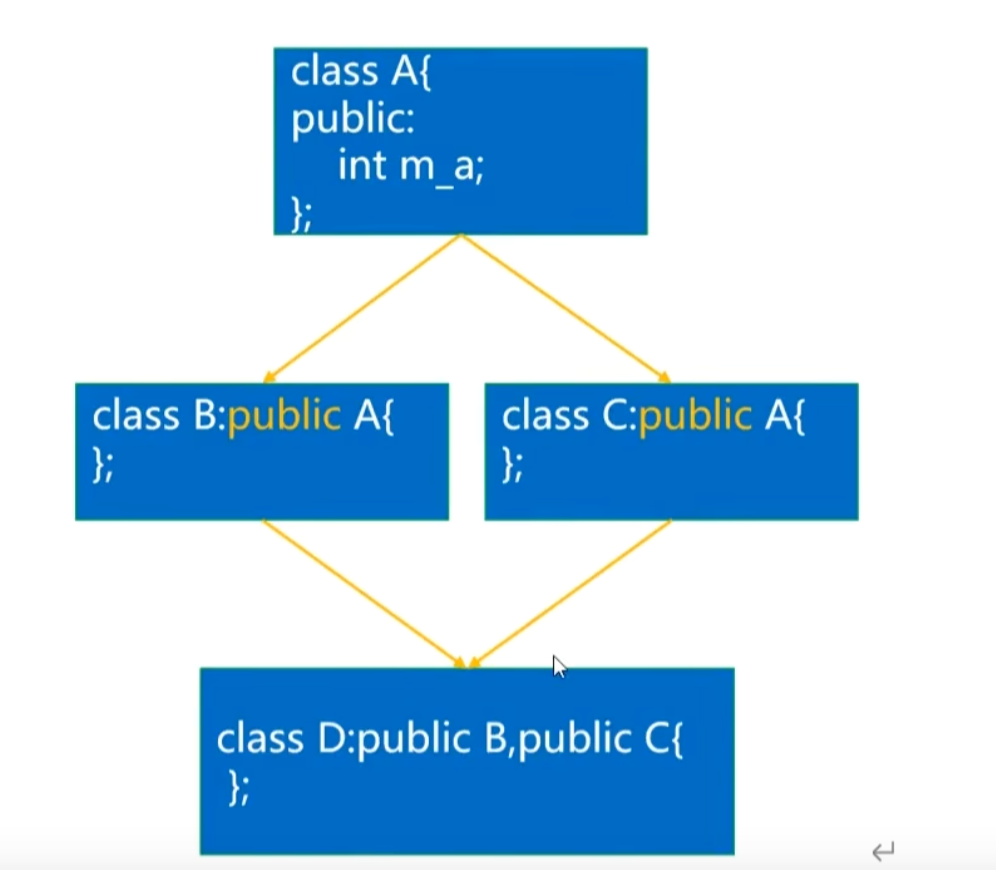
典型的菱形继承案例:
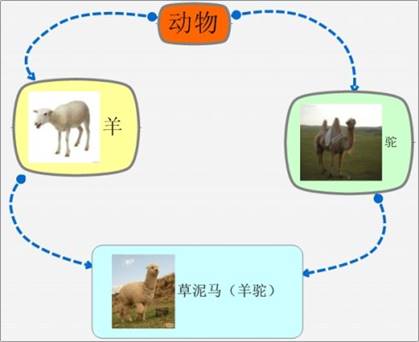
菱形继承问题:
羊继承了动物的数据,驼同样继承了动物的数据,当草泥马使用数据时,就会产生二义性。草泥马继承自动物的数据继承了两份,其实我们应该清楚,这份数据我们只需要一份就可以。
示例:
class Animal
{
public:
	int m_Age;
};

//继承前加virtual关键字后,变为虚继承
//此时公共的父类Animal称为虚基类
class Sheep : virtual public Animal {};
class Tuo   : virtual public Animal {};
class SheepTuo : public Sheep, public Tuo {};

void test01()
{
	SheepTuo st;
	st.Sheep::m_Age = 100;
	st.Tuo::m_Age = 200;

	cout << "st.Sheep::m_Age = " << st.Sheep::m_Age << endl;
	cout << "st.Tuo::m_Age = " <<  st.Tuo::m_Age << endl;
	cout << "st.m_Age = " << st.m_Age << endl;
}


int main() {

	test01();

	system("pause");

	return 0;
}
总结:
- 菱形继承带来的主要问题是子类继承两份相同的数据,导致资源浪费以及毫无意义
- 利用虚继承可以解决菱形继承问题
基类指针指向派生类对象
多态
多态的基本概念
多态就是多种形态,意思就是:同一个行为(函数调用),发生在不同的对象上,会产生不同的结果。
基类指针可以指向派生类对象;但是基类指针只能访问基类的成员。
可以将基类的成员函数设置为虚函数,就可以通过基类指针访问派生类中的同名函数了。通过类名+域解析符的形式可以访问基类的虚函数。
多态是 C++ 面向对象三大特性之一
多态分为两类
- 静态多态:函数重载、运算符重载、函数模板属于静态多态,复用函数名
- 动态多态:派生类和虚函数实现运行时多态
静态多态和动态多态区别:
- 静态多态的函数地址早绑定 - 编译阶段确定函数地址
- 动态多态的函数地址晚绑定 - 运行阶段确定函数地址
下面通过案例进行讲解多态
class Animal
{
public:
	//Speak函数就是虚函数
	//函数前面加上virtual关键字,变成虚函数,那么编译器在编译的时候就不能确定函数调用了。
	virtual void speak()
	{
		cout << "动物在说话" << endl;
	}
};

class Cat :public Animal
{
public:
	void speak()
	{
		cout << "小猫在说话" << endl;
	}
};

class Dog :public Animal
{
public:

	void speak()
	{
		cout << "小狗在说话" << endl;
	}

};
//我们希望传入什么对象,那么就调用什么对象的函数
//如果函数地址在编译阶段就能确定,那么静态联编
//如果函数地址在运行阶段才能确定,就是动态联编

void DoSpeak(Animal & animal)
{
	animal.speak();
}
//
//多态满足条件:
//1、有继承关系
//2、子类重写父类中的虚函数
//多态使用:
//父类指针或引用指向子类对象

void test01()
{
	Cat cat;
	DoSpeak(cat);


	Dog dog;
	DoSpeak(dog);
}


int main() {

	test01();

	system("pause");

	return 0;
}
总结:
多态满足条件
- 有继承关系
- 子类重写父类中的虚函数
多态使用条件
- 父类指针或引用指向子类对象
重写:函数返回值类型 函数名 参数列表 完全一致称为重写
多态案例一 - 计算器类
案例描述:
分别利用普通写法和多态技术,设计实现两个操作数进行运算的计算器类
多态的优点:
- 代码组织结构清晰
- 可读性强
- 利于前期和后期的扩展以及维护
示例:
//普通实现
class Calculator {
public:
	int getResult(string oper)
	{
		if (oper == "+") {
			return m_Num1 + m_Num2;
		}
		else if (oper == "-") {
			return m_Num1 - m_Num2;
		}
		else if (oper == "*") {
			return m_Num1 * m_Num2;
		}
		//如果要提供新的运算,需要修改源码
	}
public:
	int m_Num1;
	int m_Num2;
};

void test01()
{
	//普通实现测试
	Calculator c;
	c.m_Num1 = 10;
	c.m_Num2 = 10;
	cout << c.m_Num1 << " + " << c.m_Num2 << " = " << c.getResult("+") << endl;

	cout << c.m_Num1 << " - " << c.m_Num2 << " = " << c.getResult("-") << endl;

	cout << c.m_Num1 << " * " << c.m_Num2 << " = " << c.getResult("*") << endl;
}


//多态实现
//抽象计算器类
//多态优点:代码组织结构清晰,可读性强,利于前期和后期的扩展以及维护
class AbstractCalculator
{
public :

	virtual int getResult()
	{
		return 0;
	}

	int m_Num1;
	int m_Num2;
};

//加法计算器
class AddCalculator :public AbstractCalculator
{
public:
	int getResult()
	{
		return m_Num1 + m_Num2;
	}
};

//减法计算器
class SubCalculator :public AbstractCalculator
{
public:
	int getResult()
	{
		return m_Num1 - m_Num2;
	}
};

//乘法计算器
class MulCalculator :public AbstractCalculator
{
public:
	int getResult()
	{
		return m_Num1 * m_Num2;
	}
};


void test02()
{
	//创建加法计算器
	AbstractCalculator *abc = new AddCalculator;
	abc->m_Num1 = 10;
	abc->m_Num2 = 10;
	cout << abc->m_Num1 << " + " << abc->m_Num2 << " = " << abc->getResult() << endl;
	delete abc;  //用完了记得销毁

	//创建减法计算器
	abc = new SubCalculator;
	abc->m_Num1 = 10;
	abc->m_Num2 = 10;
	cout << abc->m_Num1 << " - " << abc->m_Num2 << " = " << abc->getResult() << endl;
	delete abc;

	//创建乘法计算器
	abc = new MulCalculator;
	abc->m_Num1 = 10;
	abc->m_Num2 = 10;
	cout << abc->m_Num1 << " * " << abc->m_Num2 << " = " << abc->getResult() << endl;
	delete abc;
}

int main() {

	//test01();

	test02();

	system("pause");

	return 0;
}
总结:C++ 开发提倡利用多态设计程序架构,因为多态优点很多
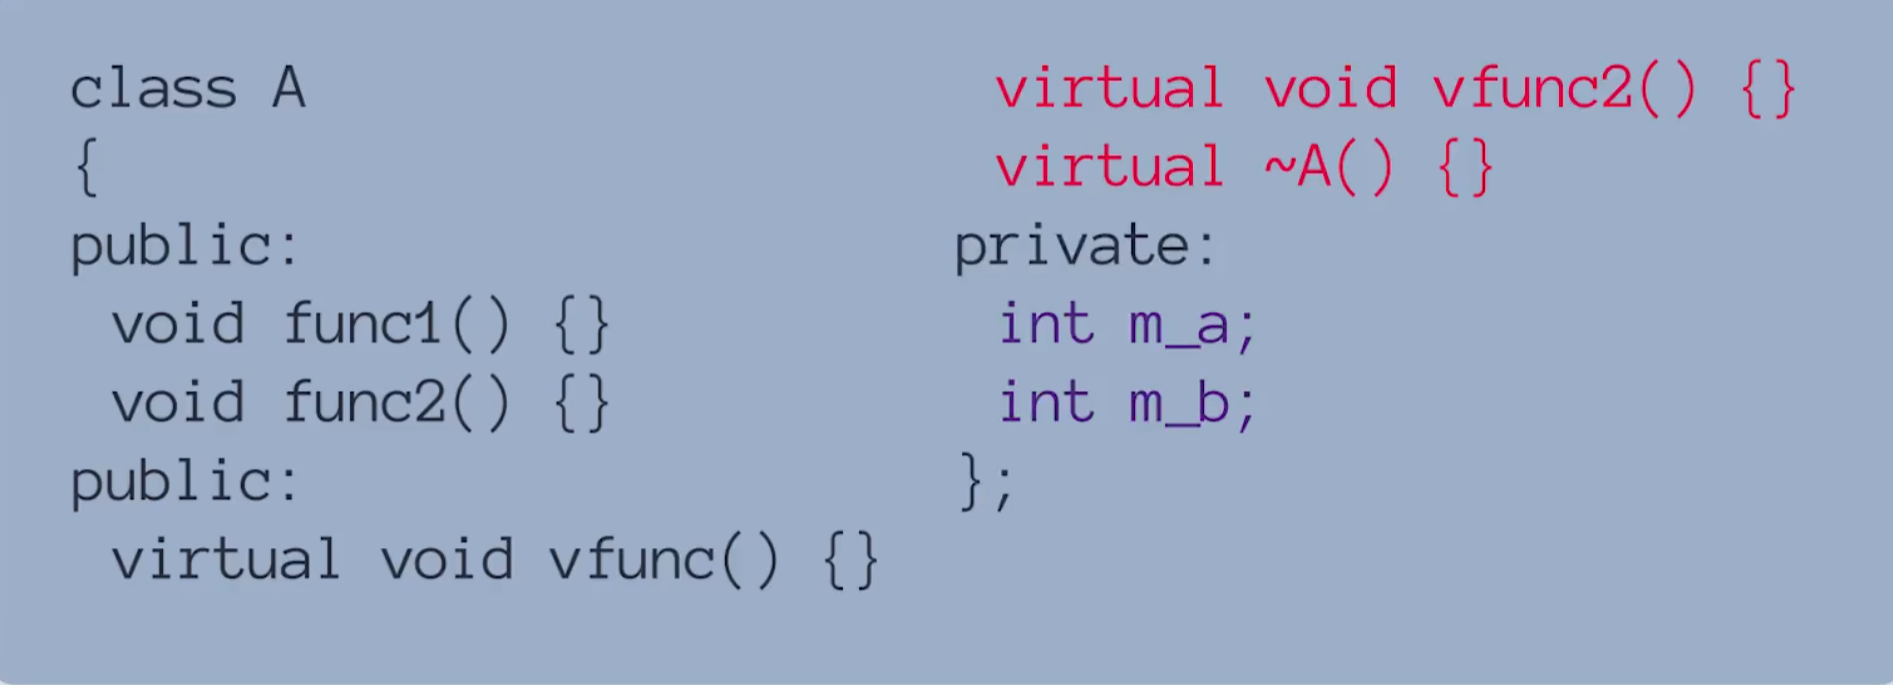
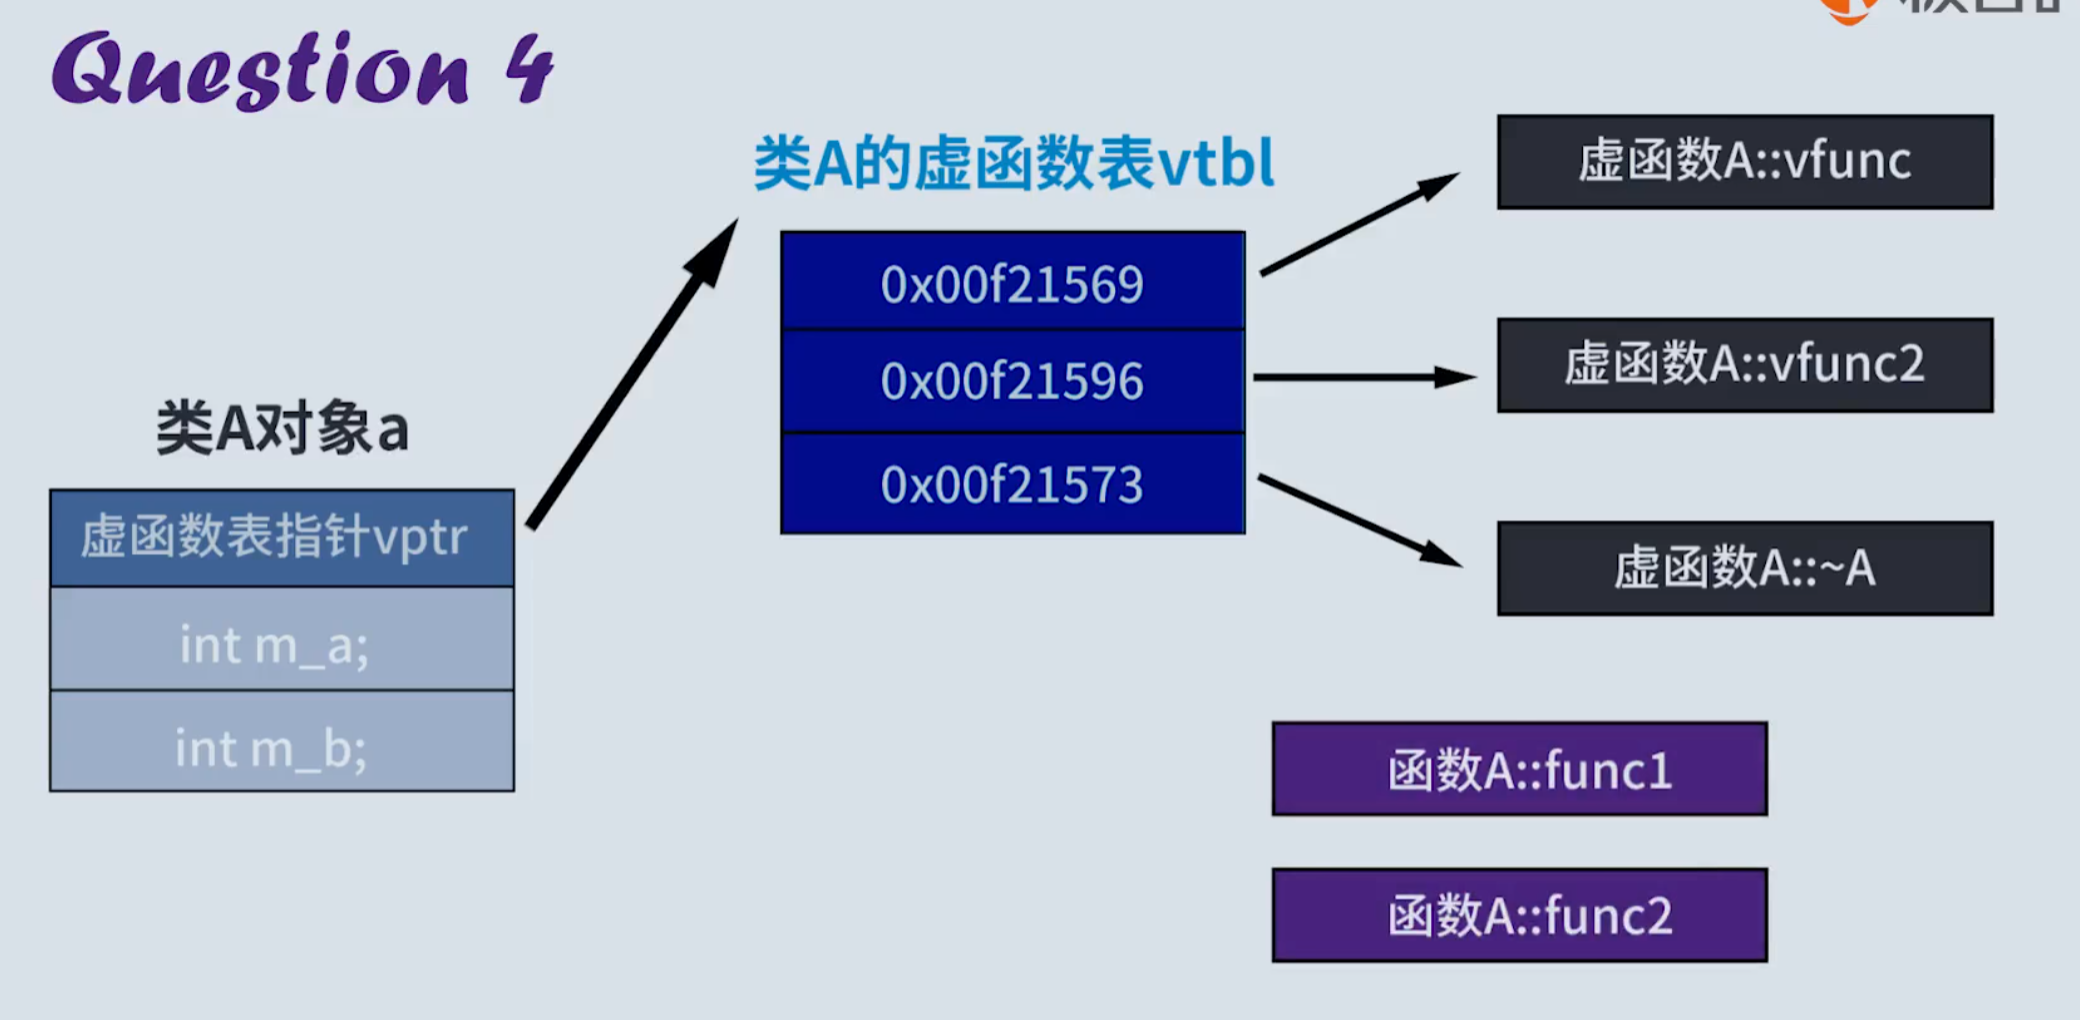
多态的内存模型
虚函数表指针 虚函数表
纯虚函数和抽象类
在多态中,通常父类中虚函数的实现是毫无意义的,主要都是调用子类重写的内容
因此可以将虚函数改为纯虚函数
纯虚函数语法: virtual 返回值类型 函数名 (参数列表)= 0 ;
当类中有了纯虚函数,这个类也称为抽象类
抽象类特点:
- 无法实例化对象,但可以创建指针或引用
- 子类必须重写抽象类中的纯虚函数,否则也属于抽象类
抽象类只能作为接口使用。
面向对象的系统可能会使用一个抽象基类为所有的外部应用程序提供一个适当的、通用的、标准化的接口。然后,派生类通过继承抽象基类,就把所有类似的操作都继承下来。
示例:
class Base
{
public:
	//纯虚函数
	//类中只要有一个纯虚函数就称为抽象类
	//抽象类无法实例化对象
	//子类必须重写父类中的纯虚函数,否则也属于抽象类
	virtual void func() = 0;
};

class Son :public Base
{
public:
	virtual void func()
	{
		cout << "func调用" << endl;
	};
};

void test01()
{
	Base * base = NULL;
	//base = new Base; // 错误,抽象类无法实例化对象
	base = new Son;
	base->func();
	delete base;//记得销毁
}

int main() {

	test01();

	system("pause");

	return 0;
}
多态案例二 - 制作饮品
案例描述:
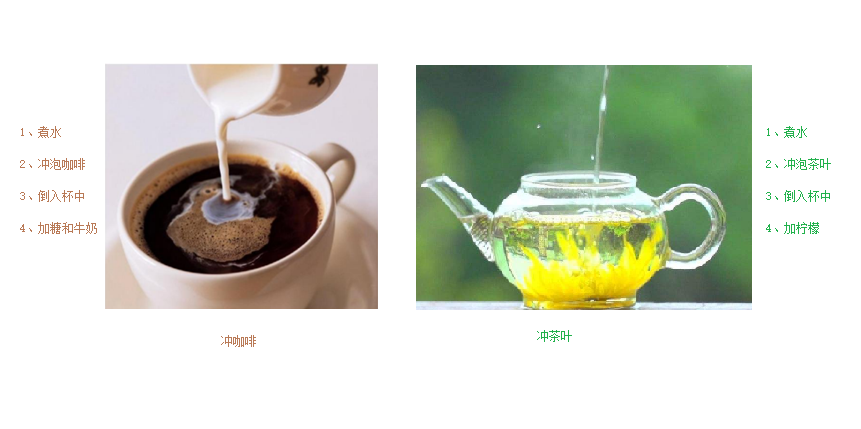
制作饮品的大致流程为:煮水 - 冲泡 - 倒入杯中 - 加入辅料
利用多态技术实现本案例,提供抽象制作饮品基类,提供子类制作咖啡和茶叶
示例:
//抽象制作饮品
class AbstractDrinking {
public:
	//烧水
	virtual void Boil() = 0;
	//冲泡
	virtual void Brew() = 0;
	//倒入杯中
	virtual void PourInCup() = 0;
	//加入辅料
	virtual void PutSomething() = 0;
	//规定流程
	void MakeDrink() {
		Boil();
		Brew();
		PourInCup();
		PutSomething();
	}
};

//制作咖啡
class Coffee : public AbstractDrinking {
public:
	//烧水
	virtual void Boil() {
		cout << "煮农夫山泉!" << endl;
	}
	//冲泡
	virtual void Brew() {
		cout << "冲泡咖啡!" << endl;
	}
	//倒入杯中
	virtual void PourInCup() {
		cout << "将咖啡倒入杯中!" << endl;
	}
	//加入辅料
	virtual void PutSomething() {
		cout << "加入牛奶!" << endl;
	}
};

//制作茶水
class Tea : public AbstractDrinking {
public:
	//烧水
	virtual void Boil() {
		cout << "煮自来水!" << endl;
	}
	//冲泡
	virtual void Brew() {
		cout << "冲泡茶叶!" << endl;
	}
	//倒入杯中
	virtual void PourInCup() {
		cout << "将茶水倒入杯中!" << endl;
	}
	//加入辅料
	virtual void PutSomething() {
		cout << "加入枸杞!" << endl;
	}
};

//业务函数
void DoWork(AbstractDrinking* drink) {
	drink->MakeDrink();
	delete drink;
}

void test01() {
	DoWork(new Coffee);
	cout << "--------------" << endl;
	DoWork(new Tea);
}


int main() {

	test01();

	system("pause");

	return 0;
}
虚析构和纯虚析构
如果用基类指针销毁派生类对象时,不能调用派生类的析构函数,在实际开发中,会把释放资源的代码写在析构函数中,比如在堆区申请的内存。如果析构函数没有被调用,会造成内存的泄露。
多态使用时,如果子类中有属性开辟到堆区,那么父类指针在释放时无法调用到子类的析构代码
解决方式:将父类中的析构函数改为虚析构或者纯虚析构
虚析构和纯虚析构共性:
- 可以解决父类指针释放子类对象
- 都需要有具体的函数实现
虚析构和纯虚析构区别:
- 如果是纯虚析构,该类属于抽象类,无法实例化对象
虚析构语法:
virtual ~类名(){}
纯虚析构语法:
virtual ~类名() = 0;
类名::~类名(){}
重要
和普通的纯虚函数不一样,纯虚析构函数必须要有代码实现,{必须有花括号}。而且 纯虚析构函数的函数体必须写在类外部
示例:
class Animal {
public:

	Animal()
	{
		cout << "Animal 构造函数调用!" << endl;
	}
	virtual void Speak() = 0;

	//析构函数加上virtual关键字,变成虚析构函数
	//virtual ~Animal()
	//{
	//	cout << "Animal虚析构函数调用!" << endl;
	//}


	virtual ~Animal() = 0;
};

Animal::~Animal()
{
	cout << "Animal 纯虚析构函数调用!" << endl;
}

//和包含普通纯虚函数的类一样,包含了纯虚析构函数的类也是一个抽象类。不能够被实例化。

class Cat : public Animal {
public:
	Cat(string name)
	{
		cout << "Cat构造函数调用!" << endl;
		m_Name = new string(name);
	}
	virtual void Speak()
	{
		cout << *m_Name <<  "小猫在说话!" << endl;
	}
	~Cat()
	{
		cout << "Cat析构函数调用!" << endl;
		if (this->m_Name != NULL) {
			delete m_Name;
			m_Name = NULL;
		}
	}

public:
	string *m_Name;
};

void test01()
{
	Animal *animal = new Cat("Tom");
	animal->Speak();

	//通过父类指针去释放,会导致子类对象可能清理不干净,造成内存泄漏
	//怎么解决?给基类增加一个虚析构函数
	//虚析构函数就是用来解决通过父类指针释放子类对象
	delete animal;
}

int main() {

	test01();

	system("pause");

	return 0;
}
总结:
1. 虚析构或纯虚析构就是用来解决通过父类指针释放子类对象
2. 如果子类中没有堆区数据,可以不写为虚析构或纯虚析构
3. 拥有纯虚析构函数的类也属于抽象类
多态案例三 - 电脑组装
案例描述:
电脑主要组成部件为 CPU(用于计算),显卡(用于显示),内存条(用于存储)
将每个零件封装出抽象基类,并且提供不同的厂商生产不同的零件,例如 Intel 厂商和 Lenovo 厂商
创建电脑类提供让电脑工作的函数,并且调用每个零件工作的接口
测试时组装三台不同的电脑进行工作
示例:
#include<iostream>
using namespace std;

//抽象CPU类
class CPU
{
public:
	//抽象的计算函数
	virtual void calculate() = 0;
};

//抽象显卡类
class VideoCard
{
public:
	//抽象的显示函数
	virtual void display() = 0;
};

//抽象内存条类
class Memory
{
public:
	//抽象的存储函数
	virtual void storage() = 0;
};

//电脑类
class Computer
{
public:
	Computer(CPU * cpu, VideoCard * vc, Memory * mem)
	{
		m_cpu = cpu;
		m_vc = vc;
		m_mem = mem;
	}

	//提供工作的函数
	void work()
	{
		//让零件工作起来,调用接口
		m_cpu->calculate();

		m_vc->display();

		m_mem->storage();
	}

	//提供析构函数 释放3个电脑零件
	~Computer()
	{

		//释放CPU零件
		if (m_cpu != NULL)
		{
			delete m_cpu;
			m_cpu = NULL;
		}

		//释放显卡零件
		if (m_vc != NULL)
		{
			delete m_vc;
			m_vc = NULL;
		}

		//释放内存条零件
		if (m_mem != NULL)
		{
			delete m_mem;
			m_mem = NULL;
		}
	}

private:

	CPU * m_cpu; //CPU的零件指针
	VideoCard * m_vc; //显卡零件指针
	Memory * m_mem; //内存条零件指针
};

//具体厂商
//Intel厂商
class IntelCPU :public CPU
{
public:
	virtual void calculate()
	{
		cout << "Intel的CPU开始计算了!" << endl;
	}
};

class IntelVideoCard :public VideoCard
{
public:
	virtual void display()
	{
		cout << "Intel的显卡开始显示了!" << endl;
	}
};

class IntelMemory :public Memory
{
public:
	virtual void storage()
	{
		cout << "Intel的内存条开始存储了!" << endl;
	}
};

//Lenovo厂商
class LenovoCPU :public CPU
{
public:
	virtual void calculate()
	{
		cout << "Lenovo的CPU开始计算了!" << endl;
	}
};

class LenovoVideoCard :public VideoCard
{
public:
	virtual void display()
	{
		cout << "Lenovo的显卡开始显示了!" << endl;
	}
};

class LenovoMemory :public Memory
{
public:
	virtual void storage()
	{
		cout << "Lenovo的内存条开始存储了!" << endl;
	}
};


void test01()
{
	//第一台电脑零件
	CPU * intelCpu = new IntelCPU;
	VideoCard * intelCard = new IntelVideoCard;
	Memory * intelMem = new IntelMemory;

	cout << "第一台电脑开始工作:" << endl;
	//创建第一台电脑
	Computer * computer1 = new Computer(intelCpu, intelCard, intelMem);
	computer1->work();
	delete computer1;

	cout << "-----------------------" << endl;
	cout << "第二台电脑开始工作:" << endl;
	//第二台电脑组装
	Computer * computer2 = new Computer(new LenovoCPU, new LenovoVideoCard, new LenovoMemory);;
	computer2->work();
	delete computer2;

	cout << "-----------------------" << endl;
	cout << "第三台电脑开始工作:" << endl;
	//第三台电脑组装
	Computer * computer3 = new Computer(new LenovoCPU, new IntelVideoCard, new LenovoMemory);;
	computer3->work();
	delete computer3;

}
C++ 内置了标准库,标准库里面有很多预定义的函数和类。需要引入头文件才能使用这些函数和类。
C++ 标准库中的函数和类通常位于 std 命名空间中。
比如 #include <iostream> ,引入这个头文件,可以使用 std::cin std::cout
#include 指令告诉编译器在编译时将指定的头文件内容插入到当前文件中,
文件操作
程序运行时产生的数据都属于临时数据,程序一旦运行结束都会被释放
通过文件可以将数据持久化。
C++ 的 io 操作类关系图:(了解就行)
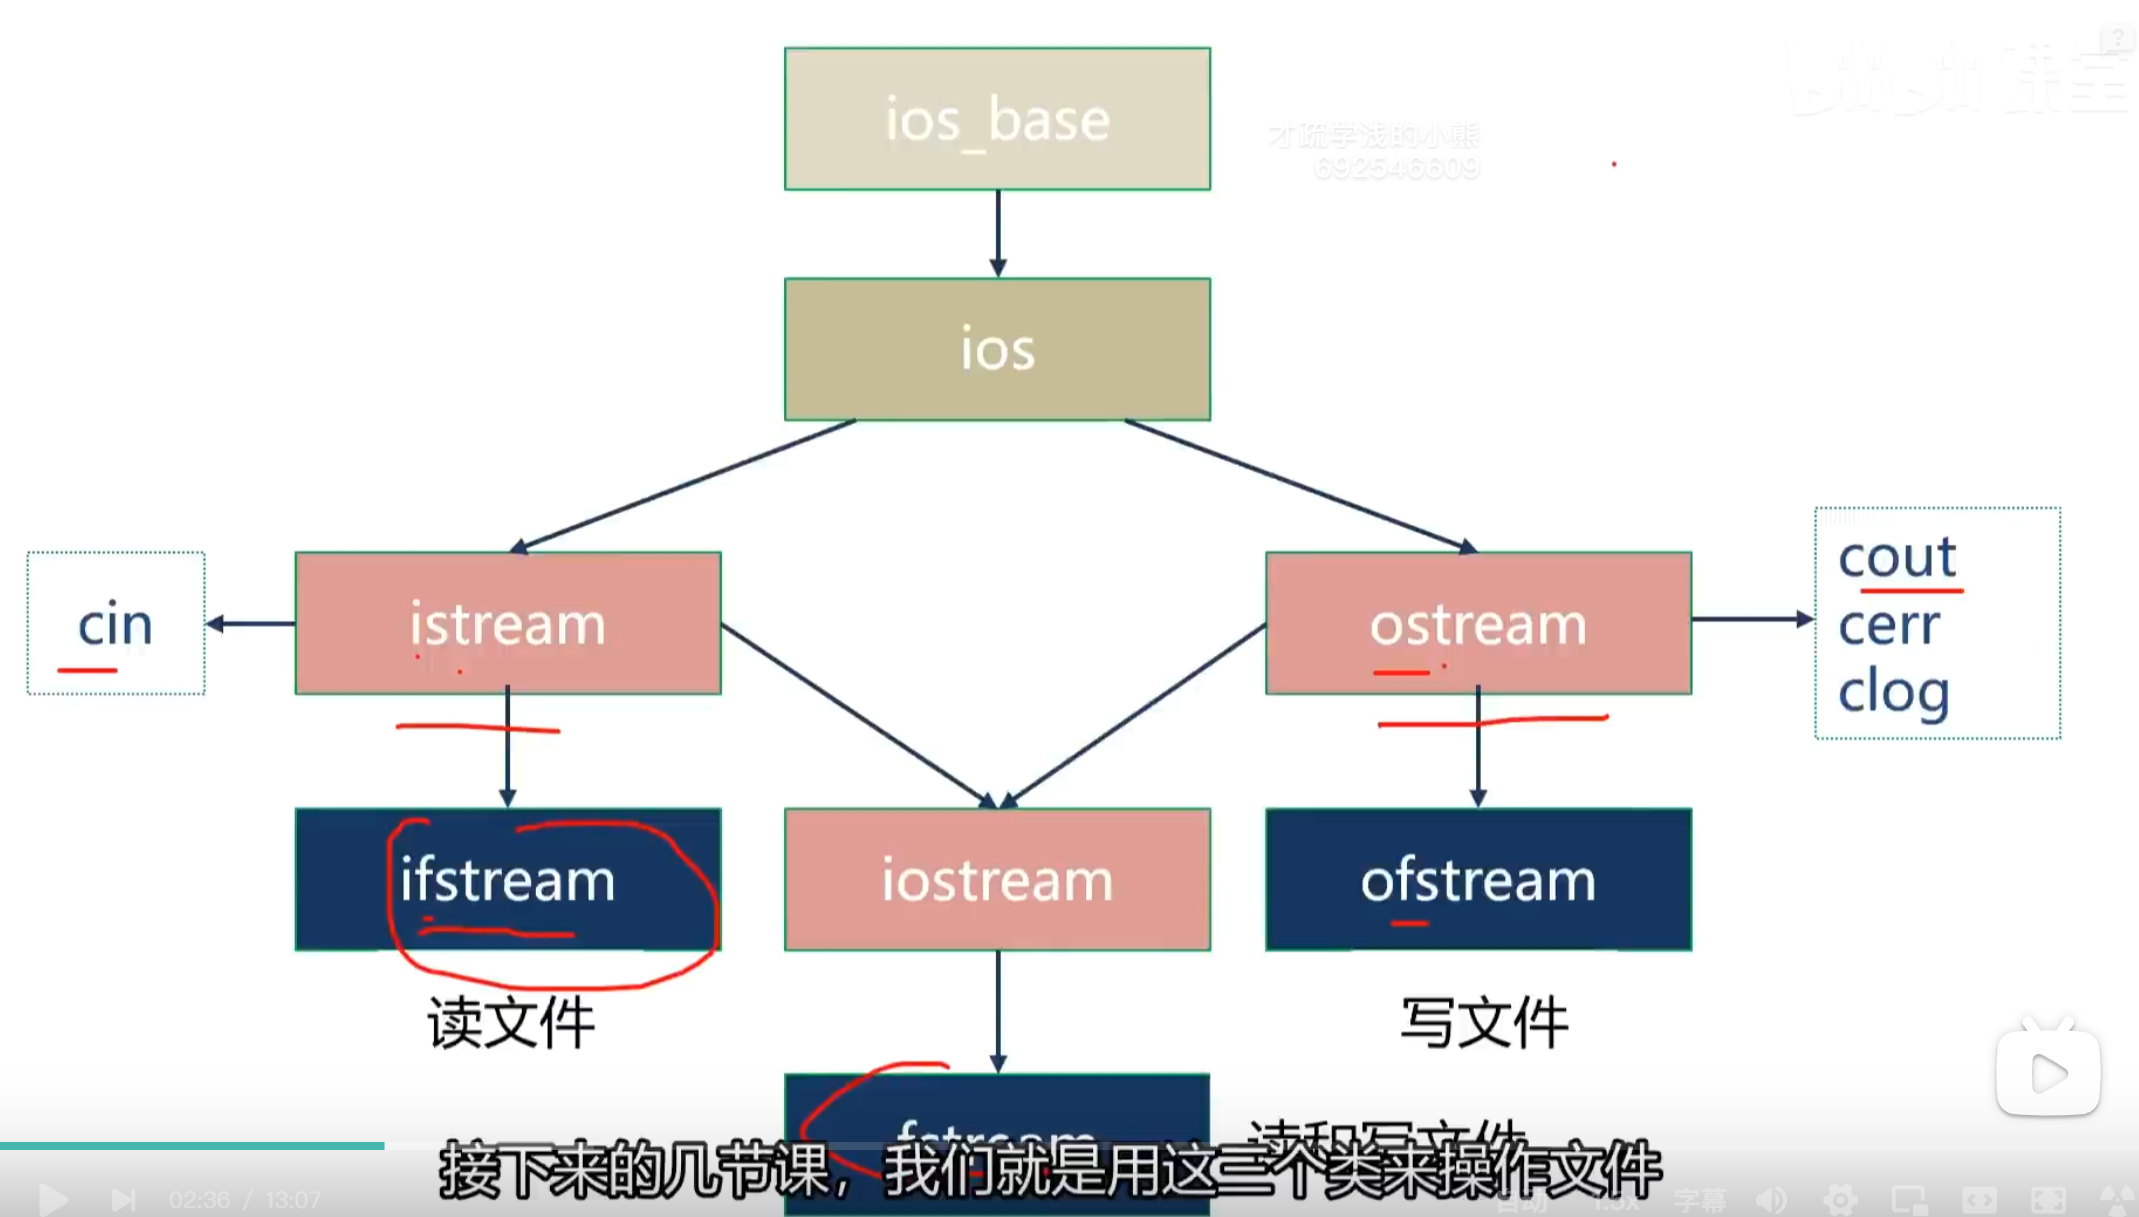
C++ 中对文件操作需要包含头文件 < fstream >
读写操作是针对当前程序而言的。读操作(in)是把文件中的数据写入内存;写操作(out)是把内存产生的数据写入到文件。
文件类型分为两种:
- 文本文件 - 文件以文本的 ASCII 码形式存储在计算机中
- 二进制文件 - 文件以文本的二进制形式存储在计算机中,用户一般不能直接读懂它们
操作文件的三大类:
- ofstream:写操作
- ifstream: 读操作
- fstream : 读写操作
文本文件
写文件
写文件步骤如下:
包含头文件
#include <fstream>
创建流对象
ofstream ofs;
打开文件 打开文件时默认会清空文件内容
ofs.open ("文件路径", 打开方式); 文件路径可以用 C 风格字符串也可以用 string。对于 ofstream,不管用哪种模式打开文件,如果文件不存在,都会创建文件。
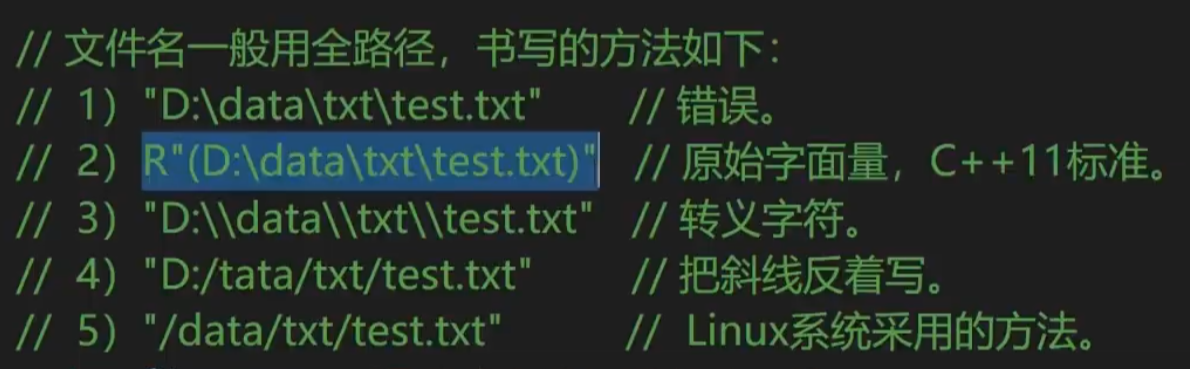
image-20260302092139568 还需要用 is_open 函数判断打开文件是否成功。
if(!ofs.is_open())
    cout << "打开文件失败" << endl;
失败的主要原因:目录空间不存在、磁盘空间已满、没有权限。
写数据
ofs <<"写入的数据"; (箭头方向是从数据到 ofs 文件对象,意思就是把数据写入到文件)
关闭文件
ofs.close (); 实际上当 ofs 这个局部对象离开作用域(比如函数结束)被销毁时,它的析构函数会自动帮你关闭文件,但是显式的指定 close 函数是一个好习惯。
文件打开方式:
| 打开方式 | 解释 |
|---|---|
| ios::in | 为读文件而打开文件 |
| ios::out | 为写文件而打开文件 |
| ios::ate | 初始位置:文件尾 |
| ios::app | 追加方式写文件 |
| ios::trunc | 如果文件存在先删除,再创建 |
| ios::binary | 二进制方式 |
注意: 文件打开方式可以配合使用,利用 |(按位或)操作符
比如用二进制方式写文件 ios::binary | ios:: out
#include <iostream>
#include <fstream>  // ofstream类需要包含的头文件。
using  namespace std;

int main()
{
	// 文件名一般用全路径,书写的方法如下:
	//  1)"D:\data\txt\test.txt"       // 错误。
	//  2)R"(D:\data\txt\test.txt)"   // 原始字面量,C++11标准。
	//  3)"D:\\data\\txt\\test.txt"   // 转义字符。
	//  4)"D:/tata/txt/test.txt"        // 把斜线反着写。
	//  5)"/data/txt/test.txt"          //  Linux系统采用的方法。
	string filename = R"(D:\data\txt\test.txt)";
	//char    filename[] = R"(D:\data\txt\test.txt)";

	// 创建文件输出流对象,打开文件,如果文件不存在,则创建它。
	// ios::out     		缺省值:会截断文件内容。
	// ios::trunc  		截断文件内容。(truncate)
	// ios::app   			不截断文件内容,只在文件未尾追加文件。(append)
	//ofstream fout(filename);
	//ofstream fout(filename, ios::out);
	//ofstream fout(filename, ios::trunc);
	//ofstream fout(filename, ios::app);

	ofstream fout;
	fout.open(filename,ios::app);

	// 判断打开文件是否成功。
	// 失败的原因主要有:1)目录不存在;2)磁盘空间已满;3)没有权限,Linux平台下很常见。
	if (fout.is_open() == false)
	{
		cout << "打开文件" << filename << "失败。\n";  return 0;
	}

	// 向文件中写入数据。
	fout << "西施|19|极漂亮\n";
	fout << "冰冰|22|漂亮\n";
	fout << "幂幂|25|一般\n";

	fout.close();	   // 关闭文件,fout对象失效前会自动调用close()。

	cout << "操作文件完成。\n";
}
读文件
读文件与写文件步骤相似,但是读取方式相对于比较多
读文件步骤如下:
包含头文件
#include <fstream>
创建流对象
ifstream ifs;
打开文件并判断文件是否打开成功
ifs.open ("文件路径", 打开方式);
读数据
三种方式读取
关闭文件
ifs.close();
示例:
#include <iostream>
#include <fstream>  // ifstream类需要包含的头文件。
#include <string>     // getline()函数需要包含的头文件。
using  namespace std;

int main()
{
	// 文件名一般用全路径,书写的方法如下:
	//  1)"D:\data\txt\test.txt"       // 错误。
	//  2)R"(D:\data\txt\test.txt)"   // 原始字面量,C++11标准。
	//  3)"D:\\data\\txt\\test.txt"   // 转义字符。
	//  4)"D:/tata/txt/test.txt"        // 把斜线反着写。
	//  5)"/data/txt/test.txt"          //  Linux系统采用的方法。
	string filename = R"(D:\data\txt\test.txt)";
	//char    filename[] = R"(D:\data\txt\test.txt)";

	// 创建文件输入流对象,打开文件,如果文件不存在,则打开文件失败。。
	// ios::in     			缺省值。
	//ifstream fin(filename);
	//ifstream fin(filename, ios::in);

	ifstream fin;
	fin.open(filename,ios::in);

	// 判断打开文件是否成功。
	// 失败的原因主要有:1)目录不存在;2)文件不存在;3)没有权限,Linux平台下很常见。
	if (fin.is_open() == false)
	{
		cout << "打开文件" << filename << "失败。\n";  return 0;
	}

	//// 第一种方法。
	//string buffer;  // 用于存放从文件中读取的内容。
	//// 文本文件一般以行的方式组织数据。
	//while (getline(fin, buffer)) //全局的getline 一行行的读 把从fin读到的数据写入到buffer
	//{
	//	cout << buffer << endl;
	//}

	//// 第二种方法。
	//char buffer[16];   // 存放从文件中读取的内容。
	//// 注意:如果采用ifstream.getline(),一定要保证缓冲区足够大。
	//while (fin.getline(buffer, 15)) //第二个参数是一次能读多少字节
	//{
	//	cout << buffer << endl;
	//}

	// 第三种方法。
	string buffer;
	while (fin >> buffer) //>>读取字符串遇到空格就会停止,可能导致读不全一行
	{
		cout << buffer << endl;
	}

	fin.close();	   // 关闭文件,fin对象失效前会自动调用close()。

	cout << "操作文件完成。\n";
}
二进制文件
二进制文件和文本文件的区别
image-20260302094123121 image-20260302102533057
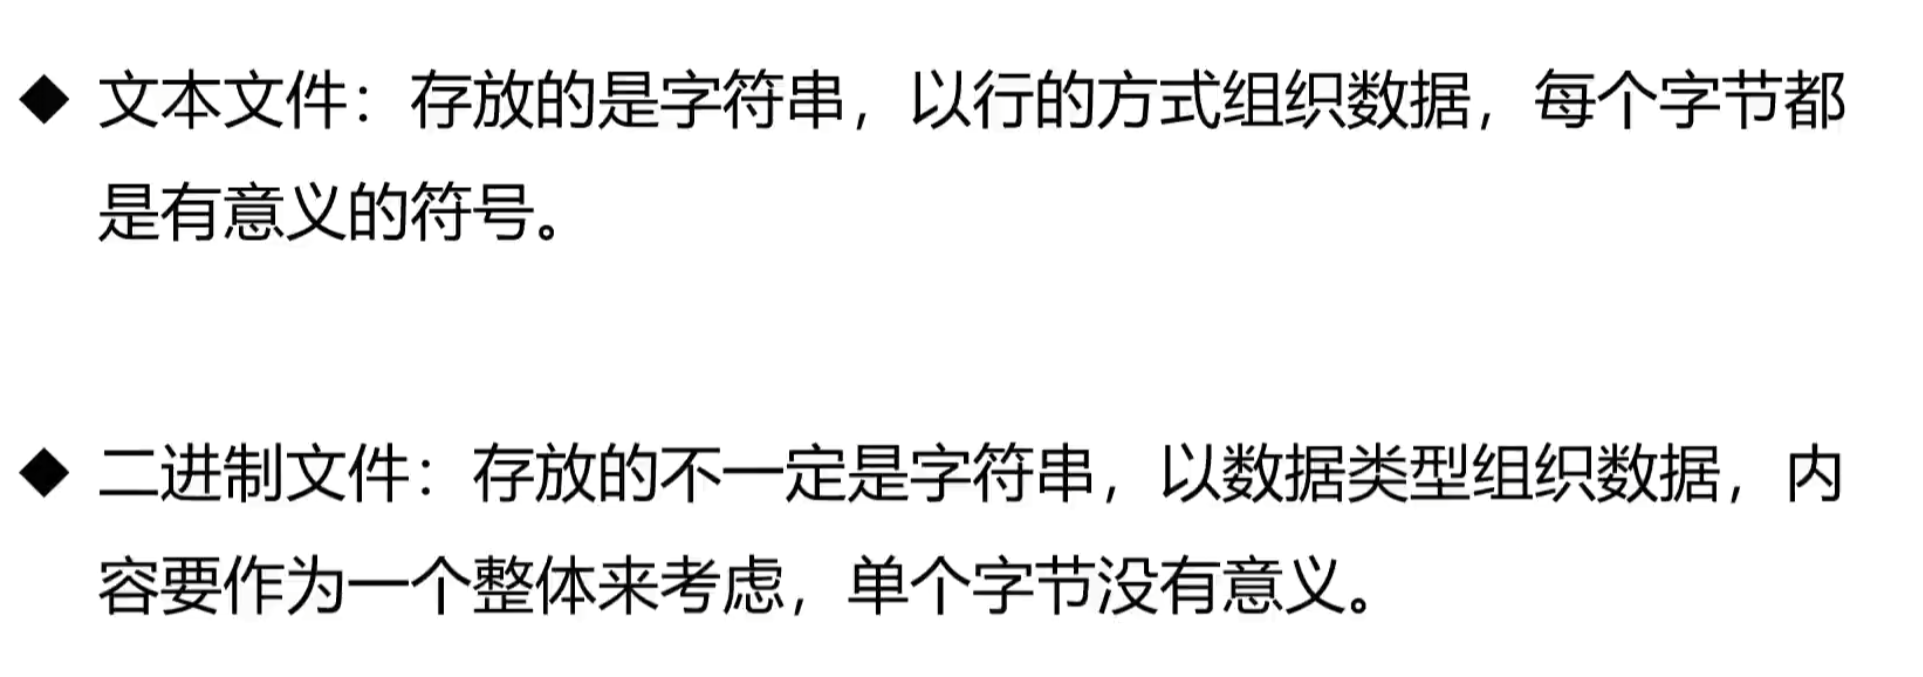
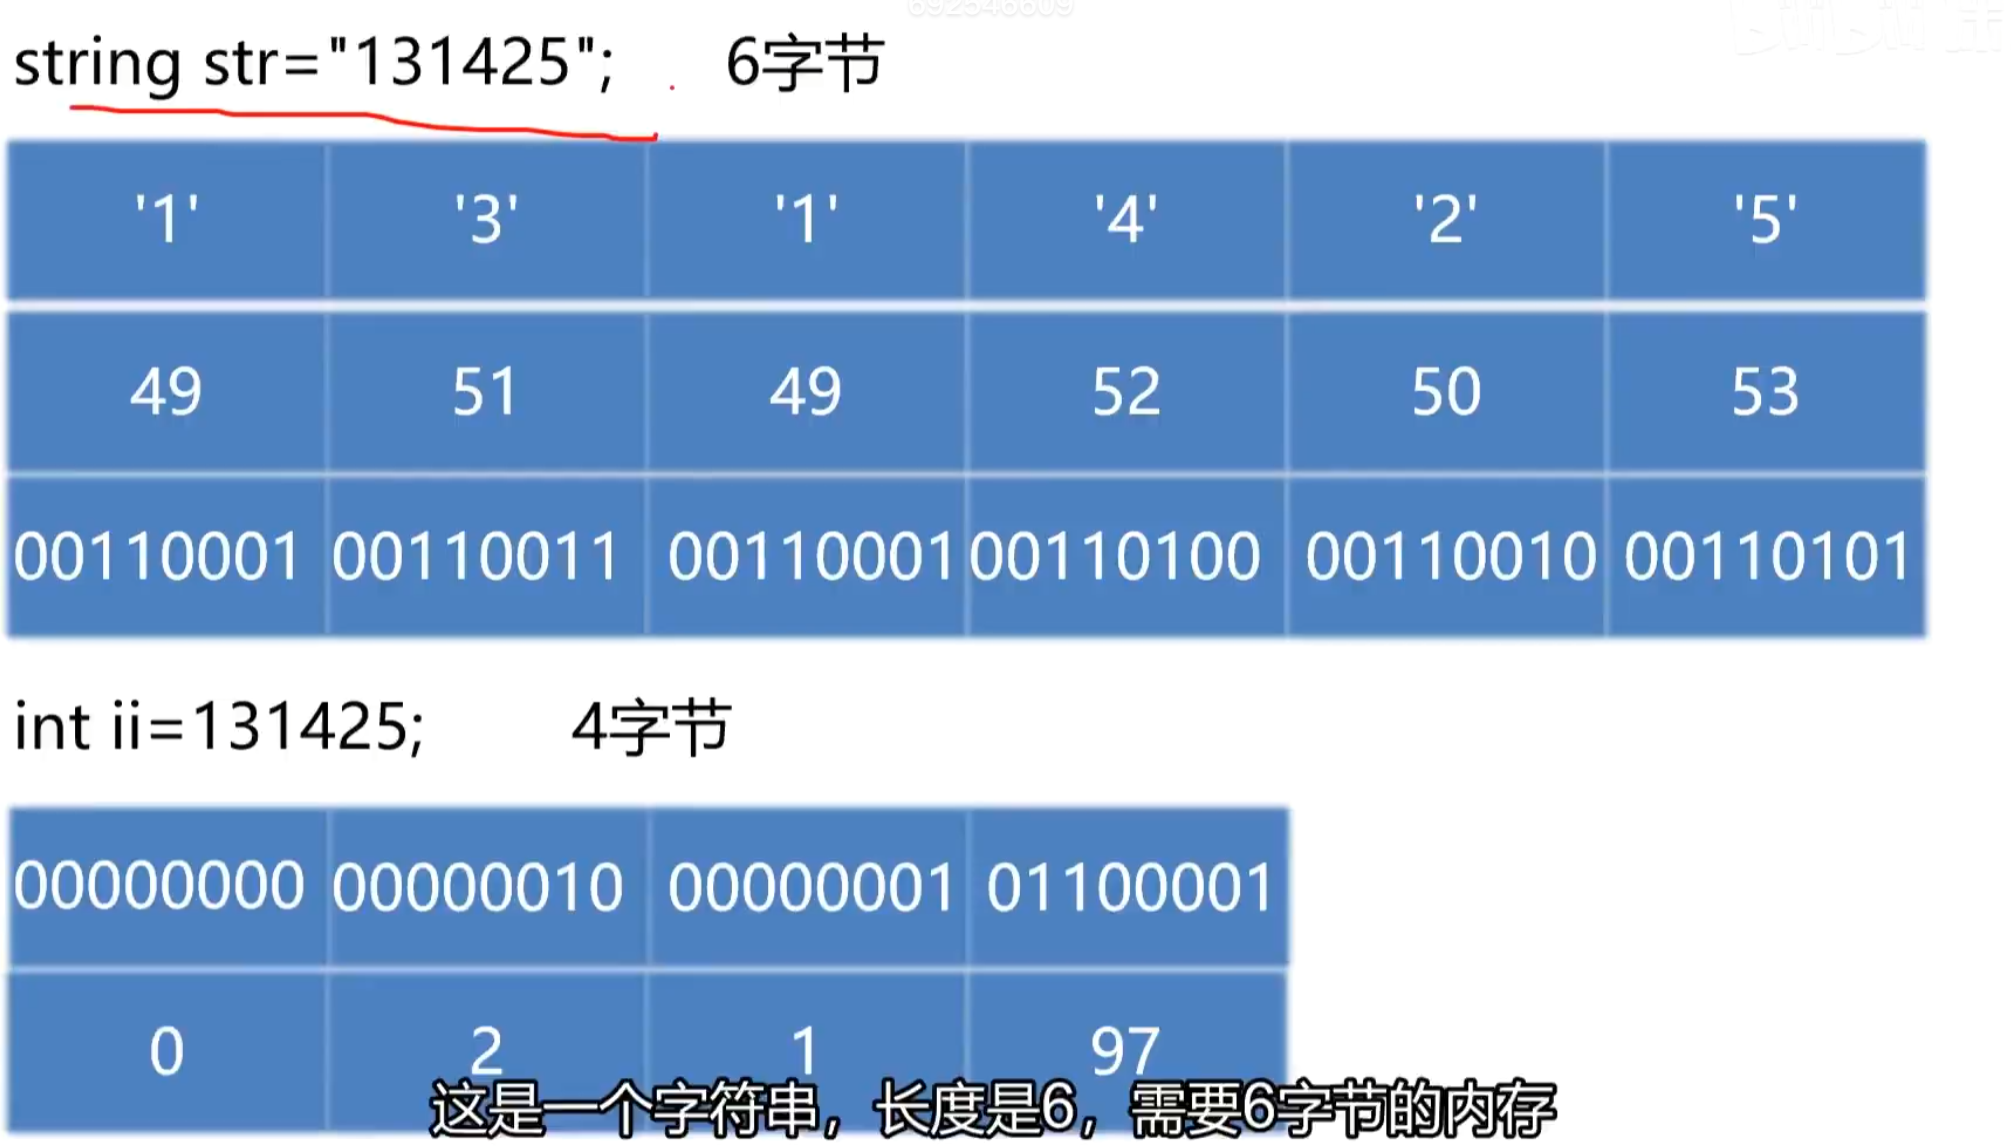
以二进制的方式对文件进行读写操作和前面介绍的文本文件有两点不同:
打开方式要指定为 ios::binary
写文件要用成员函数 write 读文件用成员函数 read,第一个参数别忘了强制类型转换。
写文件
二进制方式写文件主要利用流对象调用成员函数 write
函数原型 : ostream& write(const char * buffer,int len);
参数解释:字符指针 buffer 指向内存中一段存储空间。len 是一次写到文件的字节数
示例:
#include <iostream>
#include <fstream>  // ofstream类需要包含的头文件。
using  namespace std;

int main()
{
	// 文件名一般用全路径,书写的方法如下:
	//  1)"D:\data\bin\test.dat"       // 错误。
	//  2)R"(D:\data\bin\test.dat)"   // 原始字面量,C++11标准。
	//  3)"D:\\data\\bin\\test.dat"   // 转义字符。
	//  4)"D:/tata/bin/test.dat"        // 把斜线反着写。
	//  5)"/data/bin/test.dat"          //  Linux系统采用的方法。
	string filename = R"(D:\data\bin\test.dat)";
	//char    filename[] = R"(D:\data\bin\test.dat)";

	// 创建文件输出流对象,打开文件,如果文件不存在,则创建它。
	// ios::out     		缺省值:会截断文件内容。
	// ios::trunc  		截断文件内容。(truncate)
	// ios::app   			不截断文件内容,只在文件未尾追加文件。(append)
	// ios::binary   		以二进制方式打开文件。
	//ofstream fout(filename, ios::binary);
	//ofstream fout(filename, ios::out | ios::binary);
	//ofstream fout(filename, ios::trunc | ios::binary);
	//ofstream fout(filename, ios::app | ios::binary);

	ofstream fout;
	fout.open(filename, ios::app | ios::binary);

	// 判断打开文件是否成功。
	// 失败的原因主要有:1)目录不存在;2)磁盘空间已满;3)没有权限,Linux平台下很常见。
	if (fout.is_open() == false)
	{
		cout << "打开文件" << filename << "失败。\n";  return 0;
	}

	// 向文件中写入数据。
	struct st_girl {               // 超女结构体。
		char name[31];         // 姓名。
		int    no;                    // 编号。
		char memo[301];      // 备注。
		double weight;         // 体重。
	}girl;
	girl = { "西施",3,"中国历史第一美女。" ,45.8 };
	fout.write((const char *)& girl, sizeof(st_girl));   // 写入第一块数据。
	girl = { "冰冰",8,"也是个大美女哦。",55.2};
	fout.write((const char*)&girl, sizeof(st_girl));     // 写入第二块数据。

	fout.close();	   // 关闭文件,fout对象失效前会自动调用close()。

	cout << "操作文件完成。\n";
}
把数据写入到一个二进制文件,应该如何查看二进制文件的内容呢
读文件
二进制方式读文件主要利用流对象调用成员函数 read 怎么写的就怎么读出来。
函数原型: istream& read(char *buffer,int len);
参数解释:字符指针 buffer 指向内存中一段存储空间。len 是一次读取的字节数。要读取二进制文件全部内容,需要用循环。
示例:
#include <iostream>
#include <fstream>  // ifstream类需要包含的头文件。
using  namespace std;

int main()
{
	// 文件名一般用全路径,书写的方法如下:
	//  1)"D:\data\bin\test.dat"       // 错误。
	//  2)R"(D:\data\bin\test.dat)"   // 原始字面量,C++11标准。
	//  3)"D:\\data\\bin\\test.dat"   // 转义字符。
	//  4)"D:/tata/bin/test.dat"        // 把斜线反着写。
	//  5)"/data/bin/test.dat"          //  Linux系统采用的方法。
	string filename = R"(D:\data\bin\test.dat)";
	//char    filename[] = R"(D:\data\bin\test.dat)";

	// 创建文件输入流对象,打开文件,如果文件不存在,则打开文件失败。。
	// ios::in     			缺省值。
	// ios::binary   		以二进制方式打开文件。
	//ifstream fin(filename , ios::binary);
	//ifstream fin(filename , ios::in | ios::binary);

	ifstream fin;
	fin.open(filename, ios::in | ios::binary);

	// 判断打开文件是否成功。
	// 失败的原因主要有:1)目录不存在;2)文件不存在;3)没有权限,Linux平台下很常见。
	if (fin.is_open() == false)
	{
		cout << "打开文件" << filename << "失败。\n";  return 0;
	}

	// 二进制文件以数据块(数据类型)的形式组织数据。
	struct st_girl {               // 超女结构体。
		char name[31];         // 姓名。
		int    no;                    // 编号。
		char memo[301];      // 备注。
		double weight;         // 体重。
	}girl;
	while (fin.read((char*)&girl, sizeof(girl)))
	{
		cout << "name=" << girl.name << ",no=" << girl.no <<
			",memo=" << girl.memo << ",weight=" << girl.weight << endl;
	}

	fin.close();	   // 关闭文件,fin对象失效前会自动调用close()。

	cout << "操作文件完成。\n";
}
⚠️ 注意:在进行二进制读写结构体时,结构体内部不能有指针(如 stdvector*),因为指针存到硬盘里没有任何意义,下次读出来时那块内存早就无效了。必须使用定长的数组或者进行序列化。*
操作文本文件和二进制文件的一些细节:
1)在 windows 平台下,文本文件的换行标志是 "\r\n"。
2)在 linux 平台下,文本文件的换行标志是 "\n"。
3)在 windows 平台下,如果以文本方式打开文件,写入数据的时候,系统会将 "\n" 转换成 "\r\n";读取数据的时候,系统会将 "\r\n" 转换成 "\n"。 如果以二进制方式打开文件,写和读都不会进行转换。
为什么二进制模式必须加 ios::binary?
假如你正在用 C++ 写一张图片(图片底层全是 0 到 255 的数字)。如果不小心有一个像素点的颜色值刚好等于 10(这恰好是 \n 的 ASCII 码),如果你用文本模式写文件,C++ 会自作聪明地把它改成 13 10(\r\n)。
结果就是:你的图片文件被莫名其妙地插入了额外的数据,图片直接损坏,打不开了!
4)在 Linux 平台下,以文本或二进制方式打开文件,系统不会做任何转换。
5)以文本方式读取文件的时候,遇到换行符停止,读入的内容中没有换行符;以二制方式读取文件的时候,遇到换行符不会停止,读入的内容中会包含换行符(换行符被视为数据)。
6)在实际开发中,从兼容和语义考虑,一般:**a)以文本模式打开文本文件,用行的方法操作它;b)以二进制模式打开二进制文件,用数据块的方法操作它;c)以二进制模式打开文本文件和二进制文件,用数据块的方法操作它,这种情况表示不关心数据的内容。(例如复制文件和传输文件)**d)不要以文本模式打开二进制文件,也不要用行的方法操作二进制文件,可能会破坏二进制数据文件的格式,也没有必要。(因为二进制文件中的某字节的取值可能是换行符,但它的意义并不是换行,可能是整数 n 个字节中的某个字节)
文件操作还有第三个类 fstream ,具备 ofstream 和 ifstream 类的功能。
fstream 类既可以读文本 / 二进制文件,也可以写文本 / 二进制文件。
fstream 类的缺省模式是 ios::in | ios::out ,如果文件不存在,则创建文件;打开文件时不会清空文件原有的内容。
普遍的做法是:
1)如果只想写入数据,用 ofstream;如果只想读取数据,用 ifstream;如果想写和读数据,用 fstream,这种情况不多见。不同的类体现不同的语义。
2)在 Linux 平台下,文件的写和读有严格的权限控制。(需要的权限越少越好)
文件位置指针
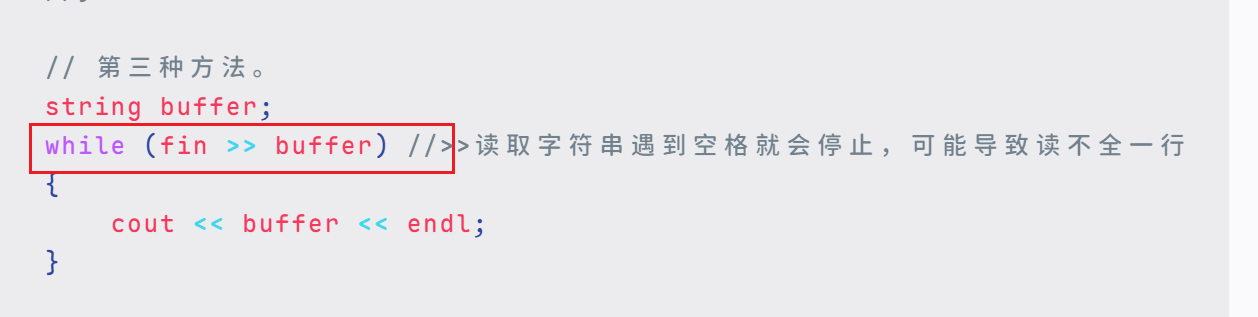
来看这段代码,创建了一个输入流 fin 对象,将文件中的数据读到 buffer 里面,之所以每次循环读取的内容不一样,是因为文件流内部维护着一个叫文件位置指针的东西。用来记录上次读到的位置。
对文件进行读 / 写操作时,文件的位置指针指向当前文件读 / 写的位置。
很多资料用 “文件读指针的位置” 和 “文件写指针的位置”,容易误导人。不管用哪个类操作文件,文件的位置指针只有一个。
获取文件位置指针:ofstream 类的成员函数是 tellp ();ifstream 类的成员函数是 tellg ();fstream 类两个都有,效果相同。
移动文件位置指针:ofstream 类的函数是 seekp ();ifstream 类的函数是 seekg ();fstream 类两个都有,效果相同。
//seekg函数有两个重载版本
//版本一
std::istream & seekg(std::streampos _Pos);
fin.seekg(128);   // 把文件指针移到第128字节。
fin.seekp(128);   // 把文件指针移到第128字节。
fin.seekg(ios::beg) // 把文件指针移动文件的开始。
fin.seekp(ios::end) // 把文件指针移动文件的结尾。

//版本二
std::istream & seekg(std::streamoff _Off,std::ios::seekdir _Way);
在ios中定义的枚举类型:
enum seek_dir {beg, cur, end};  // beg-文件的起始位置;cur-文件的当前位置;end-文件的结尾位置。
fin.seekg(30, ios::beg);    // 从文件开始的位置往后移30字节。
fin.seekg(-5, ios::cur);     // 从当前位置往前移5字节。
fin.seekg( 8, ios::cur);     // 从当前位置往后移8字节。
fin.seekg(-10, ios::end);   // 从文件结尾的位置往前移10字节。
注意往文件中写数据时,文件位置指针在开头,写入数据后应该是下面图片的最后一种情况。

随机存取是指直接移动文件的位置指针,在指定位置读取 / 写入数据。
#include <iostream>
#include <fstream>  // fstream类需要包含的头文件。
using  namespace std;

int main()
{
	string filename = R"(D:\data\txt\test.txt)";

	fstream fs;
	fs.open(filename, ios::in | ios::out);

	if (!fs.is_open())
	{
		cout << "打开文件" << filename << "失败。\n";  return 0;
	}

	fs.seekg(26);    // 把文件位置指针移动到第26字节处(注意要从第0个字节开始数)。应该在第二行亮。

	fs << "我是一只傻傻的小菜鸟。\n";

	/*string buffer;
	while (fs >> buffer)
	{
		cout << buffer << endl;
	}*/

	fs.close();	   // 关闭文件,fs对象失效前会自动调用close()。

	cout << "操作文件完成。\n";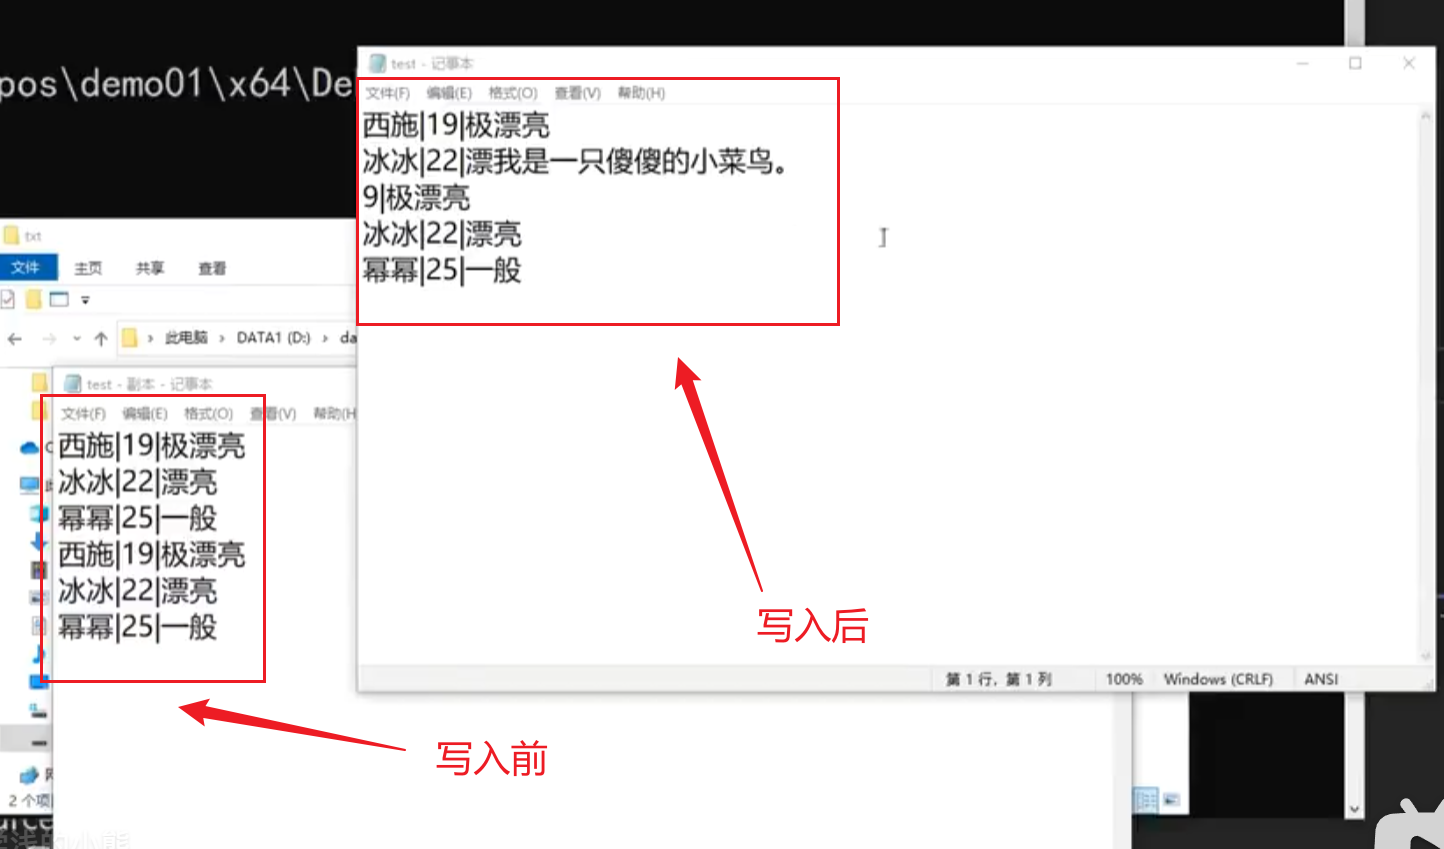
注意在写入操作时,数据会覆盖掉行末尾的 \r\n 两个字符。所以程序的运行结果和我们预想的不太一样。
如果文件不存在,各种模式都会创建文件。
ios::out 1)会截断文件;2)可以用 seekp () 移动文件指针。
ios:trunc 1)会截断文件;2)可以用 seekp () 移动文件指针。
ios::app 1)不会截断文件;2)文件指针始终在文件未尾,不能用 seekp () 移动文件指针。
ios::ate 打开文件时文件指针指向文件末尾,但是,可以在文件中的任何地方写数据。
ios::in 打开文件进行读操作,即读取文件中的数据。
ios::binary 打开文件为二进制文件,否则为文本文件。
注:ate 是 at end 的缩写,trunc 是 truncate(截断)的缩写,app 是 append(追加)的缩写。
文件缓冲区
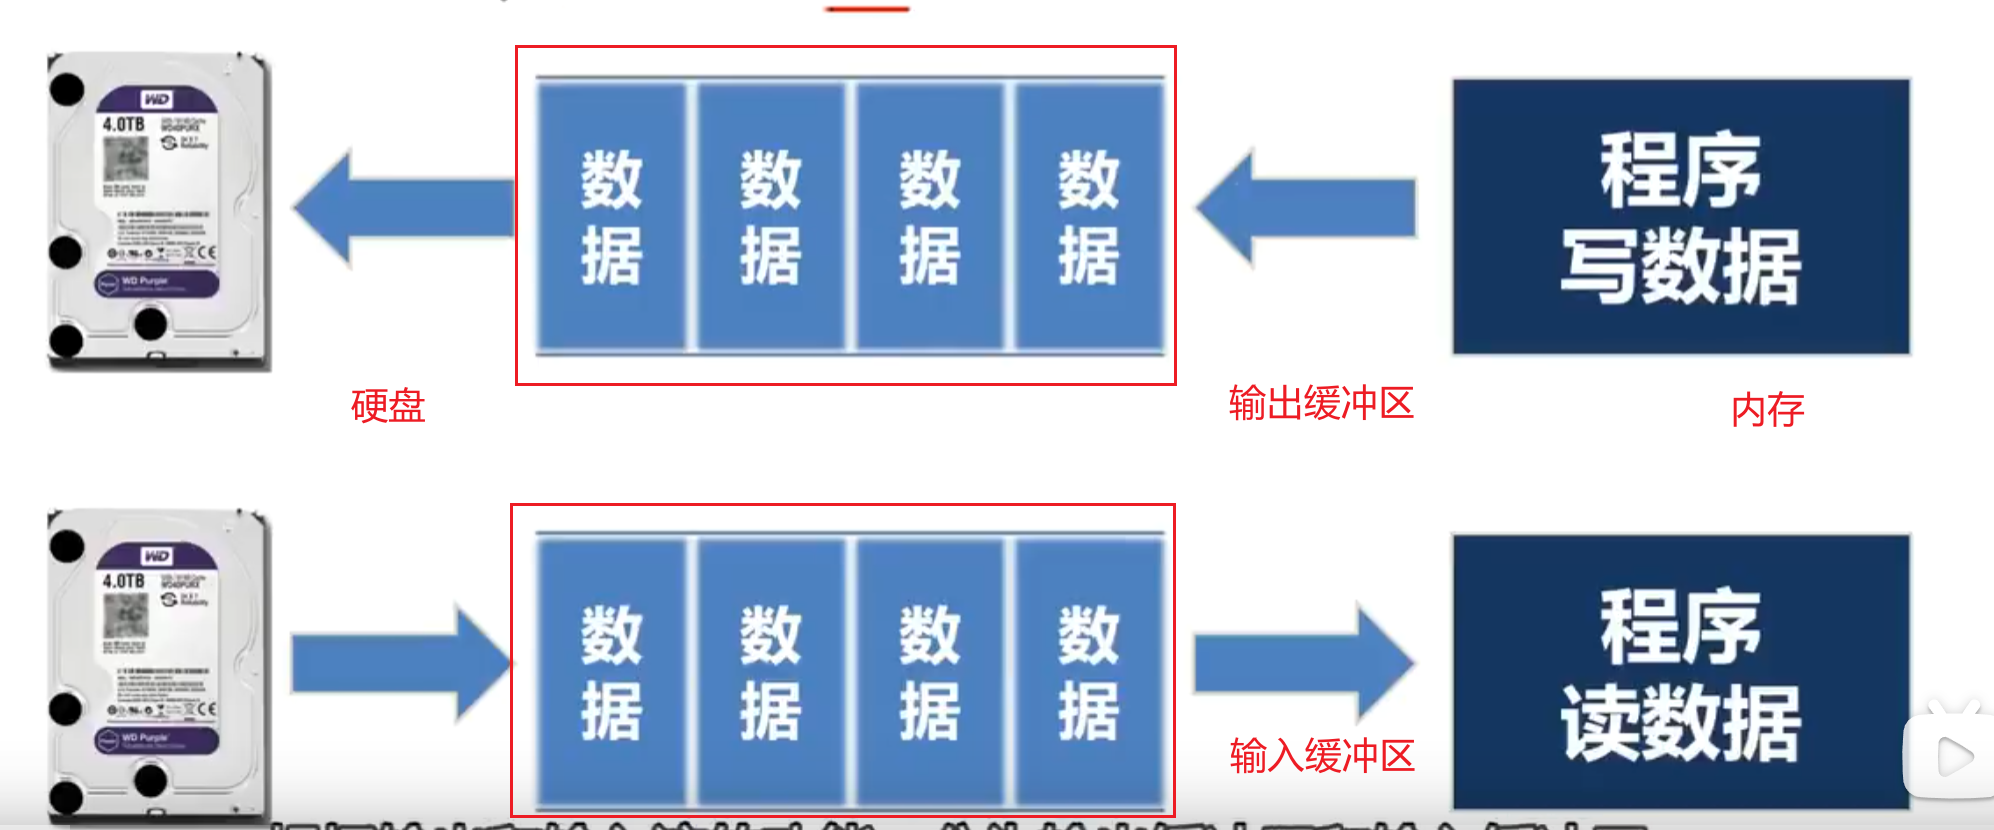
程序向硬盘写入数据,不是直接写进硬盘,而是写进一个缓冲区,等缓冲区的数据满了再写入硬盘中。可以减少硬盘的写操作。
程序读取硬盘中的数据,不是直接读,系统先把更多的数据从硬盘中读出来,放到一个缓冲区里面,程序再从缓冲区读取数据。可以减少硬盘的读操作。
缓冲区可以减少磁盘 IO 的次数,提高读写效率。
在 C++ 中,每打开一个文件,系统就会为它分配缓冲区。不同的流,缓冲区是独立的。
程序员不用关心输入缓冲区,只关心输出缓冲区就行了。
在缺省模式下,输出缓冲区中的数据满了才把数据写入磁盘,但是,这种模式不一定能满足业务的需求。
输出缓冲区的操作:
1)flush () 成员函数
刷新缓冲区,把缓冲区中的内容写入磁盘文件。
2)endl
换行,然后刷新缓冲区。
3)unitbuf
fout << unitbuf;
设置 fout 输出流,在每次操作之后自动刷新缓冲区。
4)nounitbuf
fout << nounitbuf;
设置 fout 输出流,让 fout 回到缺省的缓冲方式。
#include <iostream>
#include <fstream>          // ofstream类需要包含的头文件。
#include <unistd.h>
using  namespace std;

int main()
{
  ofstream fout("/oracle/tmp/bbb.txt");   // 打开文件。
  fout << unitbuf;

  for (int ii = 0; ii < 1000; ii++)  // 循环1000次。
  {
    fout << "ii=" << ii << ",我是一只傻傻傻傻傻傻傻傻傻傻傻傻傻傻的鸟。\n";
    //fout.flush();      // 刷新缓冲区。
    usleep(100000);    // 睡眠十分之一秒。
  }

  fout.close();  // 关闭文件。
}
每创建一个流对象,内部会有三个标志位,用于表示流的状态。
流状态有三个:eofbit、badbit 和 failbit,取值:1 - 设置;或 0 - 清除。
当三个流状成都为 0 时,表示一切顺利,good () 成员函数返回 true。
1)eofbit
当输入流操作到达文件未尾时,将设置 eofbit。
eof () 成员函数检查流是否设置了 eofbit。
2)badbit
无法诊断的失败破坏流时,将设置 badbit。(例如:对输入流进行写入;磁盘没有剩余空间)。
bad () 成员函数检查流是否设置了 badbit。
3)failbit
当输入流操作未能读取预期的字符时,将设置 failbit(非致命错误,可挽回,一般是软件错误,例如:想读取一个整数,但内容是一个字符串;文件到了未尾)I/O 失败也可能设置 failbit。
fail () 成员函数检查流是否设置了 failbit。
4)clear () 成员函数清理流状态。
5)setstate () 成员函数重置流状态。
#include <iostream>
#include <fstream>  // ifstream类需要包含的头文件。
#include <string>     // getline()函数需要包含的头文件。
using  namespace std;

int main()
{
	ifstream fin(R"(D:\data\txt\test.txt)", ios::in);

	if (!fin.is_open()) {
		cout << "打开文件" << R"(D:\data\txt\test.txt)" << "失败。\n";  return 0;
	}

	string buffer;
	/*while (fin >> buffer) {
		cout << buffer << endl;
	}*/
	while (true) {
		fin >> buffer;
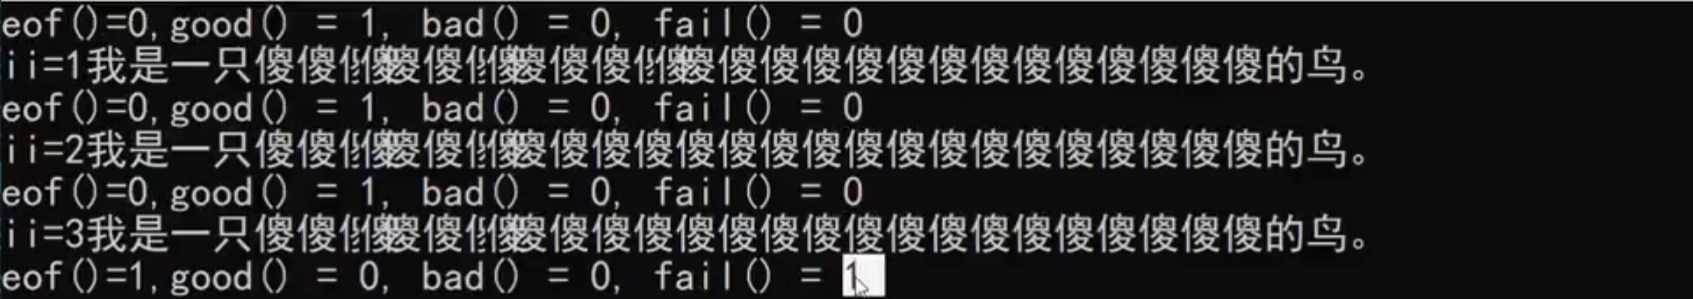
		cout << "eof()=" << fin.eof() << ",good() = " << fin.good() << ", bad() = " << fin.bad() << ", fail() = " << fin.fail() << endl;
		if (fin.eof() == true) break; //eof函数返回1代表文件位置指针到了文件末尾。

		cout << buffer << endl;
	}

	fin.close();	   // 关闭文件,fin对象失效前会自动调用close()。
}
异常
在实际开发中,如果程序抛出异常,我们不去捕获,就会异常中止,程序就会挂掉,我们不希望程序挂掉,只能进行异常捕获。
//捕获全部异常
try
    {
        // 可能抛出异常的代码。
        // throw 异常对象;
    }
catch (...)
    {
        // 不管什么异常,都在这里统一处理。
    }

//捕获指定异常
try
    {
        // 可能抛出异常的代码。
        // throw 异常对象;
    }
catch (exception1 e)
    {
        // 发生exception1异常时的处理代码。
    }
catch (exception2 e)
    {
       // 发生exception2异常时的处理代码。
    }
在 try 语句块中,如果没有发生异常,执行完 try 语句块中的代码后,将继续执行 try 语句块之后的代码;如果发生了异常,用 throw 抛出异常对象,异常对象的类型决定了应该匹配到哪个 catch 语句块,如果没有匹配到 catch 语句块,程序将调用 abort () 函数中止。
如果 try 语句块中用 throw 抛出异常对象,并且匹配到了 catch 语句块,执行完 catch 语句块中的代码后,将继续执行 catch 语句块之后的代码,不会回到 try 语句块中。
如果程序中的异常没有被捕获,程序将异常中止。
当异常被
throw出去,程序在寻找对应catch块的过程中,会发生什么?
- 过程:程序会从抛出异常的函数开始,逐层向上回溯调用栈,直到找到匹配的
catch。- 核心动作:在这个回溯的过程中,所有在
try块内部创建的局部对象,都会按照创建顺序的逆序,依次自动调用析构函数被销毁。 这个过程就叫 “栈展开”。如果 try 块内部存在我们手动
new的内存,在发生异常时由于栈展开会释放掉栈上指向这块内存的指针,而这块内存不会被释放,从而导致内存泄漏。这就是为什么在现代 C++ 中必须使用 ** 智能指针(Smart Pointers)** 和 RAII 技术的原因。
示例:
#include <iostream>
using namespace std;

int main(int argc, char* argv[])
{
    try
    {
        // 可能抛出异常的代码。
        int ii = 0;
        cout << "你是一只什么鸟?(1-傻傻鸟;2-小小鸟)";
        cin >> ii;

        if (ii==1)  throw "不好,有人说我是一只傻傻鸟。";            // throw抛出const char *类型的异常。
        if (ii==2)  throw ii;                                                             // throw抛出int类型的异常。
        if (ii==3)  throw string("不好,有人说我是一只傻傻鸟。"); // throw抛出string类型的异常。

        cout << "我不是一只傻傻鸟,哦耶。\n";
    }
    catch (int ii)
    {
        cout << "异常的类型是int=" << ii << endl;
    }
    catch (const char* ss)
    {
        cout << "异常的类型是const char *=" << ss << endl;
    }
    catch (string str)
    {
        cout << "异常的类型是string=" << str << endl;
    }
    //catch (...)  // 不管什么异常,都在这里处理。
    //{
    //    cout << "捕获到异常,具体没管是什么异常。\n";
    //}

    cout << "程序继续运行......\n";   // 执行完try ... catch ...后,将继续执行程序中其它的代码。
}
C++98 标准提出了异常规范,目的是为了让使用者知道函数可能会引发哪些异常。
void func1() throw(A, B, C);   // 表示该函数可能会抛出A、B、C类型的异常。

void func2() throw();      // 表示该函数不会抛出异常。

void func3();         // 该函数不符合C++98的异常规范。

//C++11标准弃用了异常规范,使用新增的关键字noexcept指出函数不会引发异常。

void func4() noexcept;     // 明确表示该函数不会抛出异常。
//不加 noexcept,就默认可能抛出任何异常
关键字 noexcept 也可以用作运算符,判断表达式(操作数)是否可能引发异常;如果表达式可能引发异常,则返回 false,否则返回 true。
C++ 标准库的异常
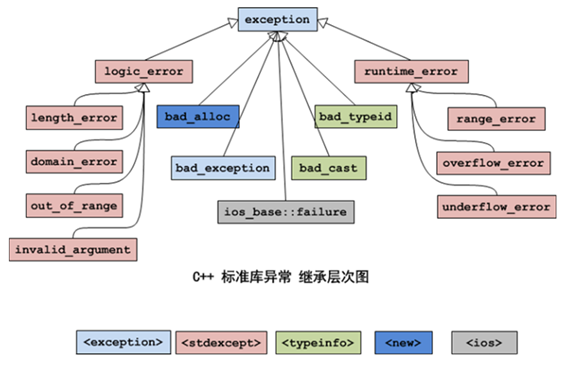
重点关注以下几个异常即可。
**stdnothrow) 选项,则返回 nullptr,不会产生异常。
#include <iostream>
using namespace std;

int main()
{
	try {
		// 如果分配内存失败,会抛出异常。
		//double* ptr = new double[100000000000];
		// 如果分配内存失败,将返回nullptr,会抛出异常。
		double* ptr = new (std::nothrow) double[100000000000];

		if (ptr == nullptr) cout << "ptr is null.\n";
	}
	catch (bad_alloc& e)
	{
		cout << "catch bad_alloc.\n";
	}
}**stdbad_cast 异常。
**stdbad_typeid 异常。
断言
断言(assertion)是一种常用的编程手段,用于排除程序中不应该出现的逻辑错误。
使用断言需要包含头文件 <cassert> 或 <assert.h> ,头文件中提供了带参数的宏 assert,用于程序在运行时进行断言。
语法: assert(表达式);
断言就是判断 (表达式) 的值,如果为 0(false),程序将调用 abort () 函数中止,如果为非 0(true),程序继续执行。
断言可以提高程序的可读性,帮助程序员定位违反了某些前提条件的错误。
注意:
断言用于处理程序中不应该发生的错误,而非逻辑上可能会发生的错误。(比如读取文件的函数,文件不存在导致的错误就是逻辑上可能会发生的错误)
不要把需要执行的代码放到断言的表达式中。
断言的代码一般放在函数 / 成员函数的第一行,表达式多为函数的形参。
#include <iostream>
#include <cassert>              // 断言assert宏需要包含的头文件。
using  namespace std;

void  copydata(void *ptr1,void *ptr2)   // 把ptr2指向的数据复制到ptr1指向的数据中。
{
    assert(ptr1&&ptr2);  // 断言ptr1和ptr2都不会为空。

    cout << "继续执行复制数据的代码......\n";
}

int main()
{
    int ii=0,jj=0;
    //assert(ii++) 这是错误的,不要把需要执行的代码放到断言的表达式中。
    copydata(&ii, &jj);
}
C++11 静态断言
assert 宏是运行时断言,在程序运行的时候才能起作用。
C++11 新增了静态断言 ``static_assert`,用于在编译时检查源代码。
使用静态断言不需要包含头文件。
语法: static_assert(常量表达式,提示信息);
注意:static_assert 的第一个参数是常量表达式。而 assert 的表达式既可以是常量,也可以是变量。
仿函数
// 1. 定义一个结构体(或类)
struct Adder {
    // 2. 重载 () 运算符
    int operator()(int a, int b) const {
        return a + b;
    }
};

int main() {
    Adder myAdd;           // 实例化一个对象
    int result = myAdd(3, 4); //对象当成函数来调用
    return 0;
}
编译器会自动把 myAdd (3,4) 翻译成 myAdd.operator ()(3,4);
仿函数的优势:
仿函数本质上就是一个类,类可以有自己的成员变量,意味着可以携带状态。
场景:我想写一个功能,每次传进一个数字,都给它加上一个 “基础值”。这个基础值是动态设置的。
#include <iostream>
#include <vector>
#include <algorithm>

// 这是一个带有状态的仿函数
class AddBase {
private:
    int base_val; // 这是它的“记忆”
public:
    // 通过构造函数设置基础值
    AddBase(int val) : base_val(val) {}

    // 执行相加操作
    int operator()(int x) const {
        return x + base_val;
    }
};

int main() {
    AddBase add5(5);   // 创建一个“加5”的仿函数对象
    AddBase add10(10); // 创建一个“加10”的仿函数对象

    std::cout << add5(100) << std::endl;  // 输出 105
    std::cout << add10(100) << std::endl; // 输出 110
}
性能碾压普通函数指针:在 STL(标准模板库)中,我们经常需要把一段逻辑作为参数传给算法,比如 std::sort 排序。如果传普通函数指针:编译器在编译期很难判断这个指针到底指向哪里,所以通常无法进行内联优化(Inline),运行时会有函数调用的开销。
如果传仿函数:仿函数是一个具体的类类型,传递的是对象。编译器在编译期清清楚楚地知道你要调用的就是这个类的 operator (),因此可以直接将代码内联展开。
sort 手写仿函数:
#include <iostream>
#include <vector>
#include <algorithm>
#include <string>

// 1. 定义一个学生结构体
struct Student {
    std::string name;
    int score;
};

// 2. 定义仿函数:按成绩降序排序的“裁判”
struct CompareScoreDesc {
    // 重载 () 运算符
    bool operator()(const Student& a, const Student& b) const {
        // 如果 a 的分数大于 b 的分数,a 就排在前面 (返回 true)
        return a.score > b.score;
    }
};

int main() {
    std::vector<Student> students = {
        {"Alice", 85},
        {"Bob", 95},
        {"Charlie", 80},
        {"David", 95}
    };

    // 3. 将仿函数的实例传递给 std::sort
    // 注意:CompareScoreDesc() 是在创建一个匿名的仿函数对象传入
    std::sort(students.begin(), students.end(), CompareScoreDesc());

    // 输出结果
    for (const auto& s : students) {
        std::cout << s.name << ": " << s.score << std::endl;
    }

    return 0;
}